Lokales KI-Coding auf einer 16-GB-GPU: Strata, OpenCode und Qwen3.8
Table of Contents
Ein lokaler Coding-Agent auf einer 16-GB-GPU ist eine praktische Option für begrenzte Entwicklungsaufgaben. Strata und OpenCode verbinden lokale Inferenz mit Dateibearbeitung, Shell-Befehlen und Testausführung. Ein gemeldeter Qwen3.8-Flash-Next-Lauf auf einer RTX 4060 Ti erledigte eine Anwendung, nachfolgende Änderungen und einen Prototyp eines Rennspiels ohne kostenpflichtige Inferenzaufrufe.
Der Ersatz eines Abonnements braucht einen breiteren Test. Die veröffentlichten Ergebnisse zeigen ein funktionierendes Setup auf einem Rechner. Sie belegen keine Gleichwertigkeit mit kostenpflichtigen Coding-Diensten über verschiedene Sprachen, Repositories oder schwierige Debugging-Aufgaben hinweg. Die Hardware enthält außerdem 64 GB Systemspeicher, der einen großen Teil des Modells trägt.
Die wichtigsten Punkte
- 16 GB beschreibt den GPU-Speicher, nicht den gesamten Speicherbedarf der gemeldeten Konfiguration.
- Prompt-Wiederverwendung ist wichtig, weil Coding-Agenten wiederholt überlappende Gesprächsverläufe senden.
- Reasoning braucht ein Budget, damit die Planung Platz für Code und Tool-Aufrufe lässt.
- Bestehende generierte Tests sind nur ein Teilbeleg, Docker und Gameplay brauchen eigene Prüfungen.
- Keine API-Ausgaben schließt Besitzkosten aus, darunter Strom und Wartungszeit.
Voraussetzungen: Ein kompatibler Computer, ausreichend freier Speicher für das ausgewählte Modell, Git, Node.js mit npm und Erfahrung mit Terminalwerkzeugen. Gleiche das gemeldete IQ3_S-Setup mit 64 GB RAM ab. Prüfe weitere Konfigurationen mit dem aktuellen Strata-Installer.
Zeit und Schwierigkeit: Mittel. Plane Zeit für große Modelldownloads und die Installation ein, bevor du die Geschwindigkeit der Aufgabenfertigstellung bewertest. Die gemeldeten Aufgabenzeiten schließen das Setup aus.
Die getestete Konfiguration
| Komponente | Gemeldete Konfiguration |
|---|---|
| GPU | NVIDIA RTX 4060 Ti, 16 GB VRAM |
| CPU | Intel Core i5-11600K |
| Systemspeicher | 64 GB RAM |
| Speicher | NVMe-SSD |
| Modell | Qwen3.8-Flash-Next, 125B MoE, IQ3_S |
| Inferenz-Engine | Strata |
| Coding-Agent | OpenCode |
| Konfigurierter Kontext | 65.536 Tokens |
| Konfiguriertes Ausgabelimit | 16.384 Tokens |
Die veröffentlichte Konfiguration und die Ergebnisse von NetworkCoder liefern diese Zahlen. Das Test-Repository meldet das Laden von 46.84GiB Expertengewichten in 28 Sekunden, wobei 4.431 Experten 8.45GiB GPU-Speicher belegen. Diese Messungen beschreiben den getesteten Lauf und garantieren keine gleiche Belegung bei einer anderen Engine-Version.
Die aktuelle Kompatibilität ist breiter als dieser Test. Nach der Prüfung am 6. Oktober 2026 dokumentiert das Strata-Projekt ausgewählte NVIDIA- und AMD-Karten mit mindestens 12 GB VRAM sowie kleinere Modelle für Systeme mit 32 GB RAM. Diese Optionen reproduzieren nicht das Experiment mit 16-GB-GPU, 64 GB RAM und IQ3_S. Prüfe GPU, Modellvariante und Laufzeitunterstützung genau, bevor du Hardware kaufst.
Wo das Modell lebt
Mixture of Experts, kurz MoE, aktiviert für jedes Token eine Teilmenge der Expertennetzwerke eines Modells. Das verringert die aktive Berechnung gegenüber der Nutzung aller Parameter bei jedem Schritt. Die übrigen Gewichte brauchen weiterhin Speicher und einen Rechenweg.
Stratas hybride Ausführung hält häufig genutzte Experten auf der GPU und bewahrt die Expertensammlung im Systemspeicher. Die CPU berechnet nicht gecachte Experten vor Ort, während die GPU gecachte Experten verarbeitet. Der Speicher enthält außerdem Modelldateien und Suchdaten. Das System packt nicht das gesamte 125B-Modell in 16 GB VRAM.
GPU-Speicher hat konkurrierende Verwendungen. Laufzeitzuweisungen, Attention-Zustand und Expert-Cache teilen sich eine begrenzte Ressource. Mehr Platz für Kontext verändert die verbleibende Expert-Cache-Kapazität. Aktuelle Strata-Versionen unterstützen auch KV-Cache-Streaming, daher unterscheidet sich die genaue Platzierung von einer älteren Konfiguration. Lies die technische Dokumentation für deine Engine-Version.
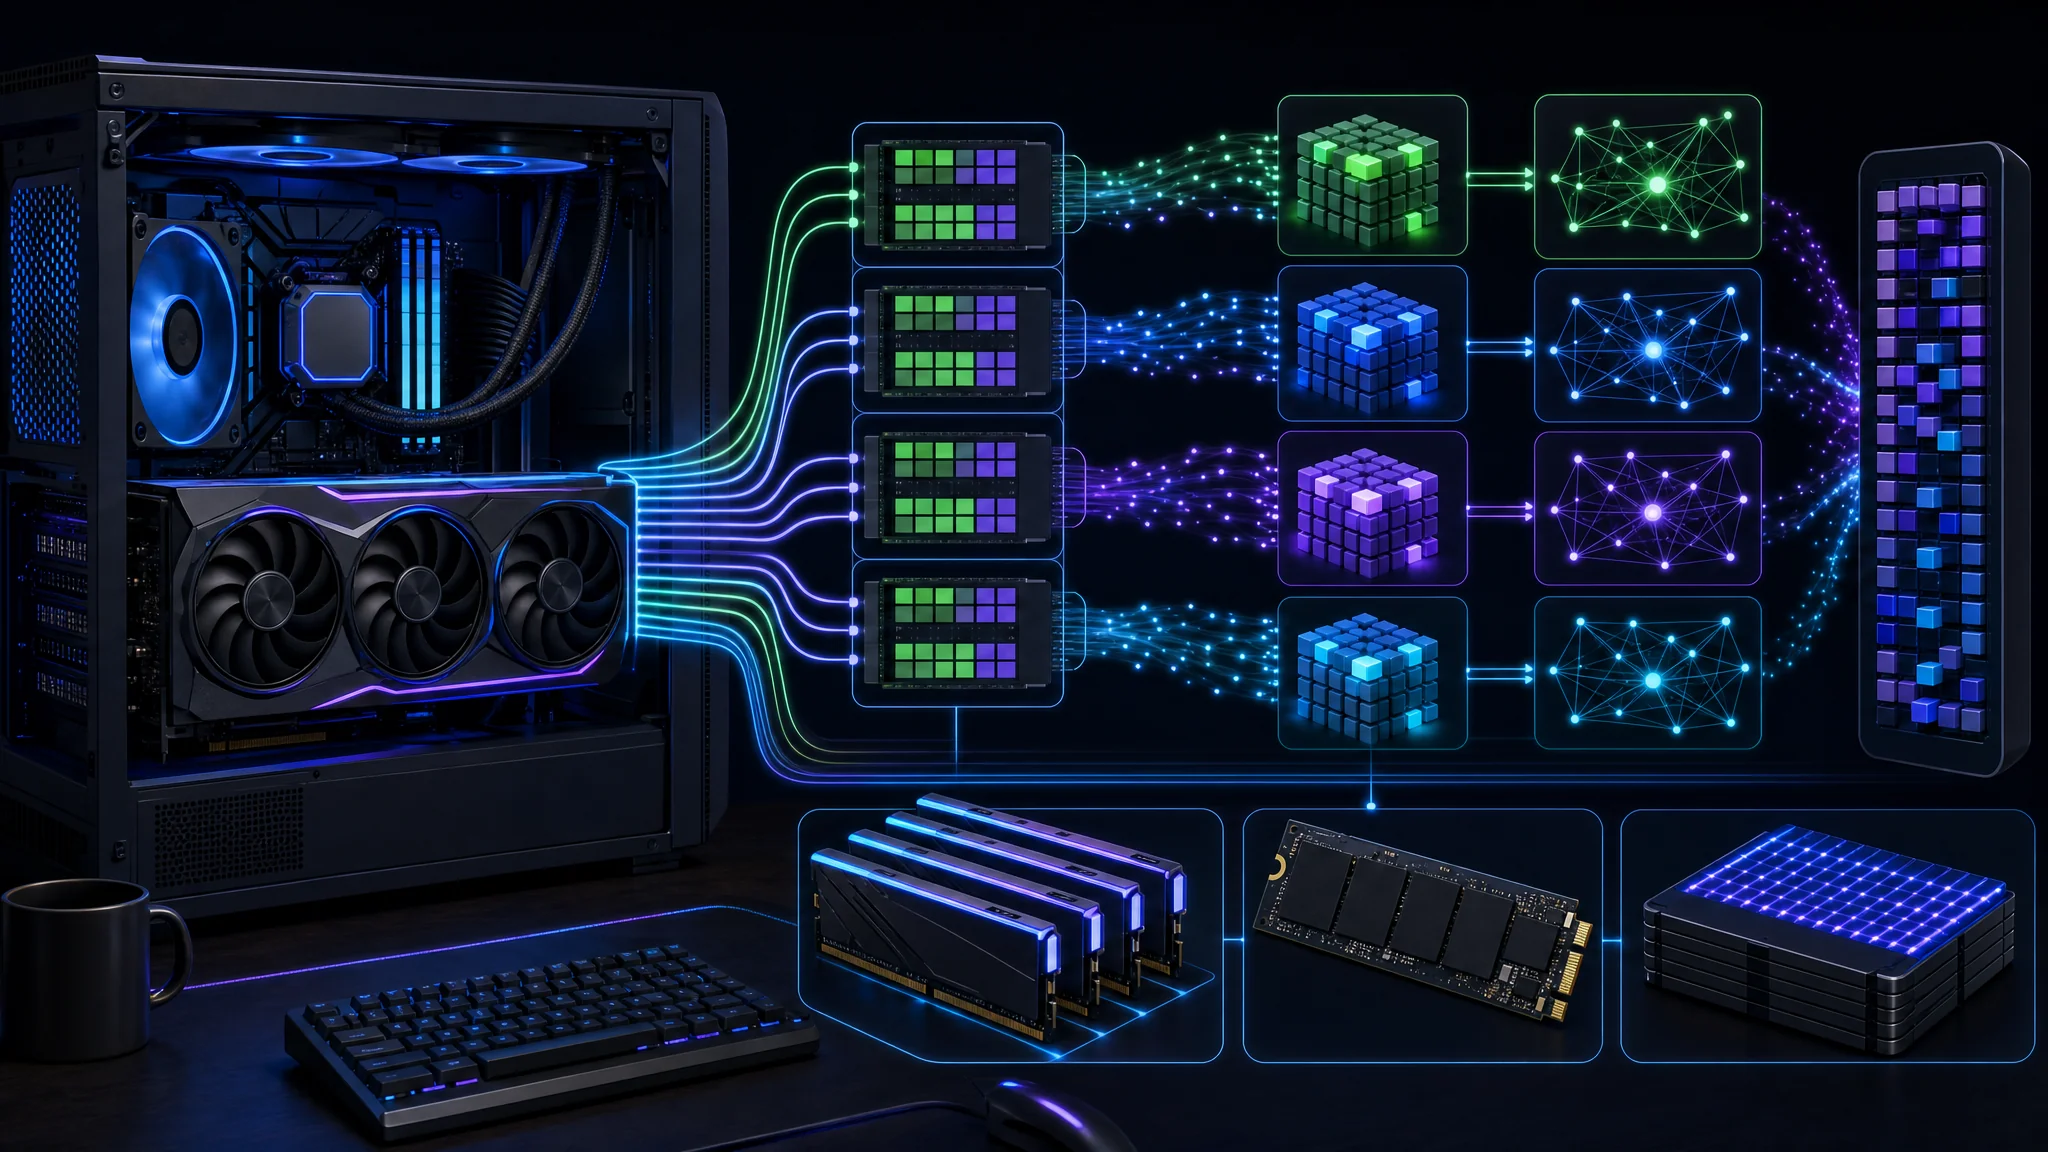
Die GPU ist ein Teil des Inferenzsystems neben CPU-Ausführung, System-RAM und Speicher
Prompt-Wiederverwendung verändert die Geschwindigkeit
Ein Coding-Agent arbeitet in einer Schleife: Er liest die Aufgabe, fordert eine Tool-Aktion an, erhält deren Ergebnis und entscheidet über die nächste Aktion. Dateiinhalte, Fehler und Testergebnisse sammeln sich im Gespräch. Agenten komprimieren oder wählen Kontext ebenfalls aus, daher sendet nicht jede Implementierung für immer die unveränderte vollständige Historie erneut.
Prefill verarbeitet Eingabetokens vor der Generierung. Decode erzeugt die Antwort. Ein System mit schnellem Decode, aber langsamer wiederholter Prefill-Verarbeitung lässt dich zwischen Tool-Aufrufen weiter warten.
Das gemeldete Timing für 44K Tokens nutzte Prefix-Wiederverwendung. Strata verwendete bereits verarbeitete Gesprächsinhalte erneut. Der wachsende Prompt war in ungefähr ein bis drei Sekunden bereit. Das ist ein nützlicher Beleg für eine fortlaufende Agentensitzung. Es belegt nicht die Verarbeitung von 44.000 vollständig neuen Tokens aus dem Stand in einer Sekunde.
| Messung | Was aufgezeichnet werden sollte |
|---|---|
| Kalter Prompt | Zeit für neue Inhalte ohne wiederverwendbaren Prefix-Zustand |
| Warme Fortsetzung | Zeit nach dem Anhängen eines Tool-Ergebnisses an bestehenden Kontext |
| Generierungsgeschwindigkeit | Tokens pro Sekunde während der Antwort |
| Aufgabendauer | Planung, Generierung, Tools, Tests und Wiederholungen zusammen |
Zwei Caches dienen unterschiedlichen Zwecken. Der Expert-Cache hält häufig genutzte Gewichte nahe an der GPU-Berechnung. Prefix-Wiederverwendung vermeidet wiederholte Arbeit an früheren Eingaben. Eine hohe Trefferquote im Expert-Cache beweist keinen Treffer im Prompt-Cache.
Was die Aufgaben gezeigt haben
| Aufgabe | Gemeldete Zeit | Gemeldetes Ergebnis |
|---|---|---|
| Task-Manager erstellen | 3m 38s | Express-API, Oberfläche, 5/5 Tests |
| Bearbeitung reparieren und Daten ergänzen | 4m 58s | Änderungen abgeschlossen, 6/6 Tests |
| Export/Import und Packaging ergänzen | 3m 48s | 7/7 Tests, Docker-Build nicht verifiziert |
| Rennspiel, erster Versuch | 6m 35s | Ausgabe beim Reasoning erschöpft, kein Code |
| Rennspiel, Wiederholung mit Budget | 4m 51s | Spiel erzeugt, JavaScript-Syntax geprüft |
Die veröffentlichte Ergebnisdatei zeichnet Ausgabe-Geschwindigkeiten von 48–52 Tokens pro Sekunde für die erste Aufgabe, 40–43 für die zweite und 37–44 für die dritte auf. „Bis zu 52“ ist ein Spitzenwert innerhalb dieser Beobachtungen, keine dauerhafte Rate für jede Aufgabe.
Die ersten drei Aufgaben erweitern eine Anwendung. Die Werte 5/5, 6/6 und 7/7 beschreiben aufeinanderfolgende Testsuiten. Ihre Addition belegt keine 18 unabhängigen Fähigkeiten. Auch vom selben Agenten geschriebene Tests brauchen eine Prüfung auf Abdeckung und sinnvolle Aussagen.
Die Wiederherstellung der Umgebung gehörte zur Arbeit. Der Agent erholte sich von einem unpassenden Shell-Befehl und erkannte während der Tests einen veralteten Anwendungsserver. Das sind nützliche Verhaltensweisen. Das Beenden eines bestehenden Prozesses braucht in einer gemeinsam genutzten Entwicklungsumgebung bewusste Berechtigungen.
Docker blieb unverifiziert. Der Agent schrieb ein Dockerfile, hatte aber keine laufende Docker-Engine für den Build. Bestandene Anwendungstests außerhalb des Containers belegen kein funktionierendes Image. Der Spiel-Wiederholungsversuch prüfte ebenfalls die Syntax und öffnete einen Browser, während dem Agenten eine direkte visuelle Bestätigung des Gameplays fehlte.
Platz für Ausgabe reservieren
{
  "reasoning_budget_tokens": 8000
}
Führe diese Einstellung in die vorhandene Konfiguration strata-iq3_s.json ein, erhalte die übrigen Felder und starte das ausgewählte Strata-Modell neu. Es ist eine Strata-Einstellung, keine ersetzende OpenCode-Konfigurationsdatei. Prüfe das aktive Budget in der Startausgabe.
Strata dokumentiert ein festes Reasoning-Budget, das die Denkphase beendet und zu einer Antwort übergeht. Ein Wert auf Anfrageebene überschreibt den konfigurierten Standard. Die Einstellung unterscheidet sich von einer allgemeinen Anweisung zum Reasoning-Aufwand wie niedrig oder hoch.
Der erste Spielversuch erschöpfte seine Zuweisung von 16.384 Tokens während der Planung. Der Wiederholungsversuch nutzte ein Denkbudget von 8.000 Tokens und lieferte Code. Das spricht für eine begrenzte Reasoning-Phase bei dieser Arbeitslast. Es belegt nicht, dass 8.000 für jede Aufgabe optimal sind.
Die verbleibende Ausgabe ist ein Maximum, keine Reservierungsgarantie. Wenn ein Limit von 8.000 Tokens innerhalb eines Gesamtlimits von 16.384 Tokens vollständig verbraucht würde, blieben vor anderem Overhead ungefähr 8.384 Tokens. Das Ergebnisprotokoll meldet beim Wiederholungsversuch 11.054 geschriebene Tokens ohne vollständige Aufteilung zwischen Reasoning und Code. Interpretiere das nicht als 8.000 Reasoning-Tokens plus 11.054 Code-Tokens innerhalb desselben Limits.
Nutze für kleine Änderungen ein kleineres Budget und teste größere Budgets für Aufgaben mit mehr Analysebedarf. Prüfe die vollständige Dateiausgabe, den Abschlussstatus und die Testergebnisse. Mehr Planungszeit hilft nur, wenn sie die gelieferte Änderung verbessert.
Strata und OpenCode verbinden
git clone https://github.com/Niko1221/Strata.git
cd Strata
./setup.sh
Das ist der Linux-Einstieg für die Einrichtung. Prüfe die aktuellen Installationsanweisungen und nutze START-HERE.bat für den dokumentierten Windows-Weg. Wähle die originale Qwen3.8-Flash-Next-IQ3_S-Variante und einen Kontext von 65.536 Tokens, um die gemeldete Konfiguration anzunähern. Speichere Engine-Version und ausgewählte Modelldateien mit deinen Benchmark-Notizen.
npm install -g opencode-ai
Installiere OpenCode mit den
offiziellen Anweisungen
. Setze in einem separaten Terminal STRATA_BASE_URL auf die von Strata ausgegebene lokale API-Basis einschließlich des Suffixes /v1. Binde die Inferenz für dieses Setup an den lokalen Rechner.
{
  "provider": {
    "strata": {
      "npm": "@ai-sdk/openai-compatible",
      "name": "Strata local",
      "options": {
        "baseURL": "{env:STRATA_BASE_URL}",
        "apiKey": "local"
      },
      "models": {
        "qwen3.8-flash-next-iq3_s": {
          "name": "Qwen3.8-Flash-Next IQ3_S",
          "limit": { "context": 65536, "output": 16384 }
        }
      }
    }
  },
  "model": "strata/qwen3.8-flash-next-iq3_s"
}
Führe den Provider-Block in ~/.config/opencode/opencode.json ein, ohne bestehende Einstellungen zu entfernen. Das passt das
veröffentlichte Beispiel
an, indem der lokale Endpunkt aus einer Umgebungsvariable geladen wird. OpenCode dokumentiert
benutzerdefinierte Provider
und
Umgebungsersetzung
.
local sind Platzhalter-Anmeldedaten, passend zum nicht authentifizierten lokalen Setup des Beispiels. Sie schützen keinen Server. Wenn deine Strata-Instanz Authentifizierung aktiviert, übergib die konfigurierten Anmeldedaten über den passenden lokalen Secret-Mechanismus.
Starte opencode in einer wegwerfbaren Projektkopie und wähle das konfigurierte Modell. Prüfe den ausgewählten Provider, bevor du Code sendest. Die clientseitige Kontexterklärung vergrößert den Server-Kontext nicht, und ein Fenster von 65.536 Tokens lässt nicht 65.536 Tokens für Eingaben übrig, wenn auch Ausgaberaum gebraucht wird.
Lokale Inferenz und Berechtigungen
{
  "permission": {
    "edit": "ask",
    "bash": "ask"
  }
}
Führe diese ersten Berechtigungen in die OpenCode-Konfiguration ein, während du den Agenten bewertest. Die Berechtigungsdokumentation erklärt die verfügbaren Kontrollen. Dateiänderungen und Shell-Ausführung betreffen deinen Rechner unabhängig vom Ort der Inferenz.
Lokale Inferenz macht nicht jedes Tool lokal. Paketdownloads, Webtools, externe Integrationen und optionale Freigaben verwenden Netzwerkdienste. Prüfe aktivierte Tools, bevor du private Repositories bearbeitest. „Das Modell läuft lokal“ ist eine engere Aussage als „Nichts verlässt den Rechner“.
Fehlerbehebung beim ersten Lauf
| Symptom | Zuerst prüfen |
|---|---|
| Provider nicht verfügbar | Strata läuft und die Umgebungsvariable erreicht den OpenCode-Prozess |
| Modell fehlt in der Auswahl | Provider-ID und Modell-ID stimmen mit der gespeicherten Konfiguration überein |
| Kontextlimit-Fehler | Prompt-Länge plus gewünschte Ausgabe passen in das aktive Serverfenster |
| Planung ohne Code | Reasoning-Budget, Gesamtausgabelimit und Abschlussstatus |
| Langsame Fortsetzung | Prefix-Wiederverwendung, Speicherdruck, Expert-Cache-Verhalten und konkurrierende Prozesse |
| Docker-Befehl scheitert | Eine funktionierende Engine ist verfügbar, nicht nur ihr Kommandozeilen-Client |
Ändere jeweils nur eine Einstellung und wiederhole dieselbe Aufgabe aus einem gespeicherten Ausgangszustand. So trennst du eine Konfigurationsverbesserung von einem anderen Prompt oder einem einfacheren Test.
Ersetzt es ein Abonnement?
| Lokales Setup ist einen Test wert | Halte eine weitere Option bereit |
|---|---|
| Vorhandene kompatible Hardware | Hardware ausschließlich für eine ungeprüfte Arbeitslast kaufen |
| Begrenzte Anwendungsänderungen | Große unbekannte Repositories und schwierige Migrationen |
| Wiederholbare Abnahmetests | Aufgaben ohne zuverlässige Korrektheitsprüfung |
| Zeit für Laufzeitwartung | Arbeit mit minimalem Setup und Supportaufwand |
Keine API-Ausgaben sind relevant, besonders wenn Hardware schon vorhanden ist. Strom, Hardware-Abschreibung, Speicher und Wartungszeit sind darin nicht enthalten. Auch das angezeigte Nullkostenfeld erfasst diese Ausgaben nicht.
Ein Abonnementvergleich braucht gleiche Aufgaben. Führe dasselbe Ausgangsrepository, dieselben Anweisungen und dieselben Abnahmekontrollen durch beide Systeme. Zeichne Wiederholungen und menschliche Korrekturen zusammen mit der verstrichenen Zeit auf. Beziehe den fehlgeschlagenen ersten Spielversuch in die Bewertung des gesamten Workflows ein, statt nur den erfolgreichen Wiederholungsversuch zu melden.
Ein nützlicher lokaler Agent muss nicht allgemein überlegen sein. Wenn er deine Routineänderungen zuverlässig erledigt und eine kleine Gruppe schwieriger Aufgaben einem anderen Tool überlässt, verändert er bereits, welche kostenpflichtigen Dienste du brauchst. Entscheide anhand angenommener Arbeit in deinen eigenen Projekten.
Demonstration und nächste Schritte
Weitere Ansicht: Die Demonstration des lokalen 125B-Coding-Agenten . Die oben gemeldeten Messungen gehören zum veröffentlichten Test und sind kein unabhängiger Benchmark dieses Artikels.
- Wiederhole eine kleine Aufgabe mit festen Abnahmekriterien und einer gespeicherten Ausgangsrevision.
- Miss kalte und warme Durchläufe statt Prefix-Wiederverwendung als kalte Prefill-Geschwindigkeit zu behandeln.
- Prüfe das Packaging separat mit erfolgreichem Image-Build, Start und Prüfungen auf Containerebene.
- Untersuche die generierten Tests und ergänze Fälle, die die Implementierung nicht vorausgesehen hat.
- Vergleiche erledigte Arbeit mit deinem aktuellen Coding-Tool, bevor du Abonnements änderst.
Für Hardwareplanung lies den Leitfaden zu lokalen KI-Modellen und GPU-Kontext . Für das Verhalten gehosteter Modelle siehe Provider-Routing und Kosten bei OpenRouter .
Related Posts