OpenRouter-Provider-Routing: Modellqualität, Tokenlimits und reale Kosten
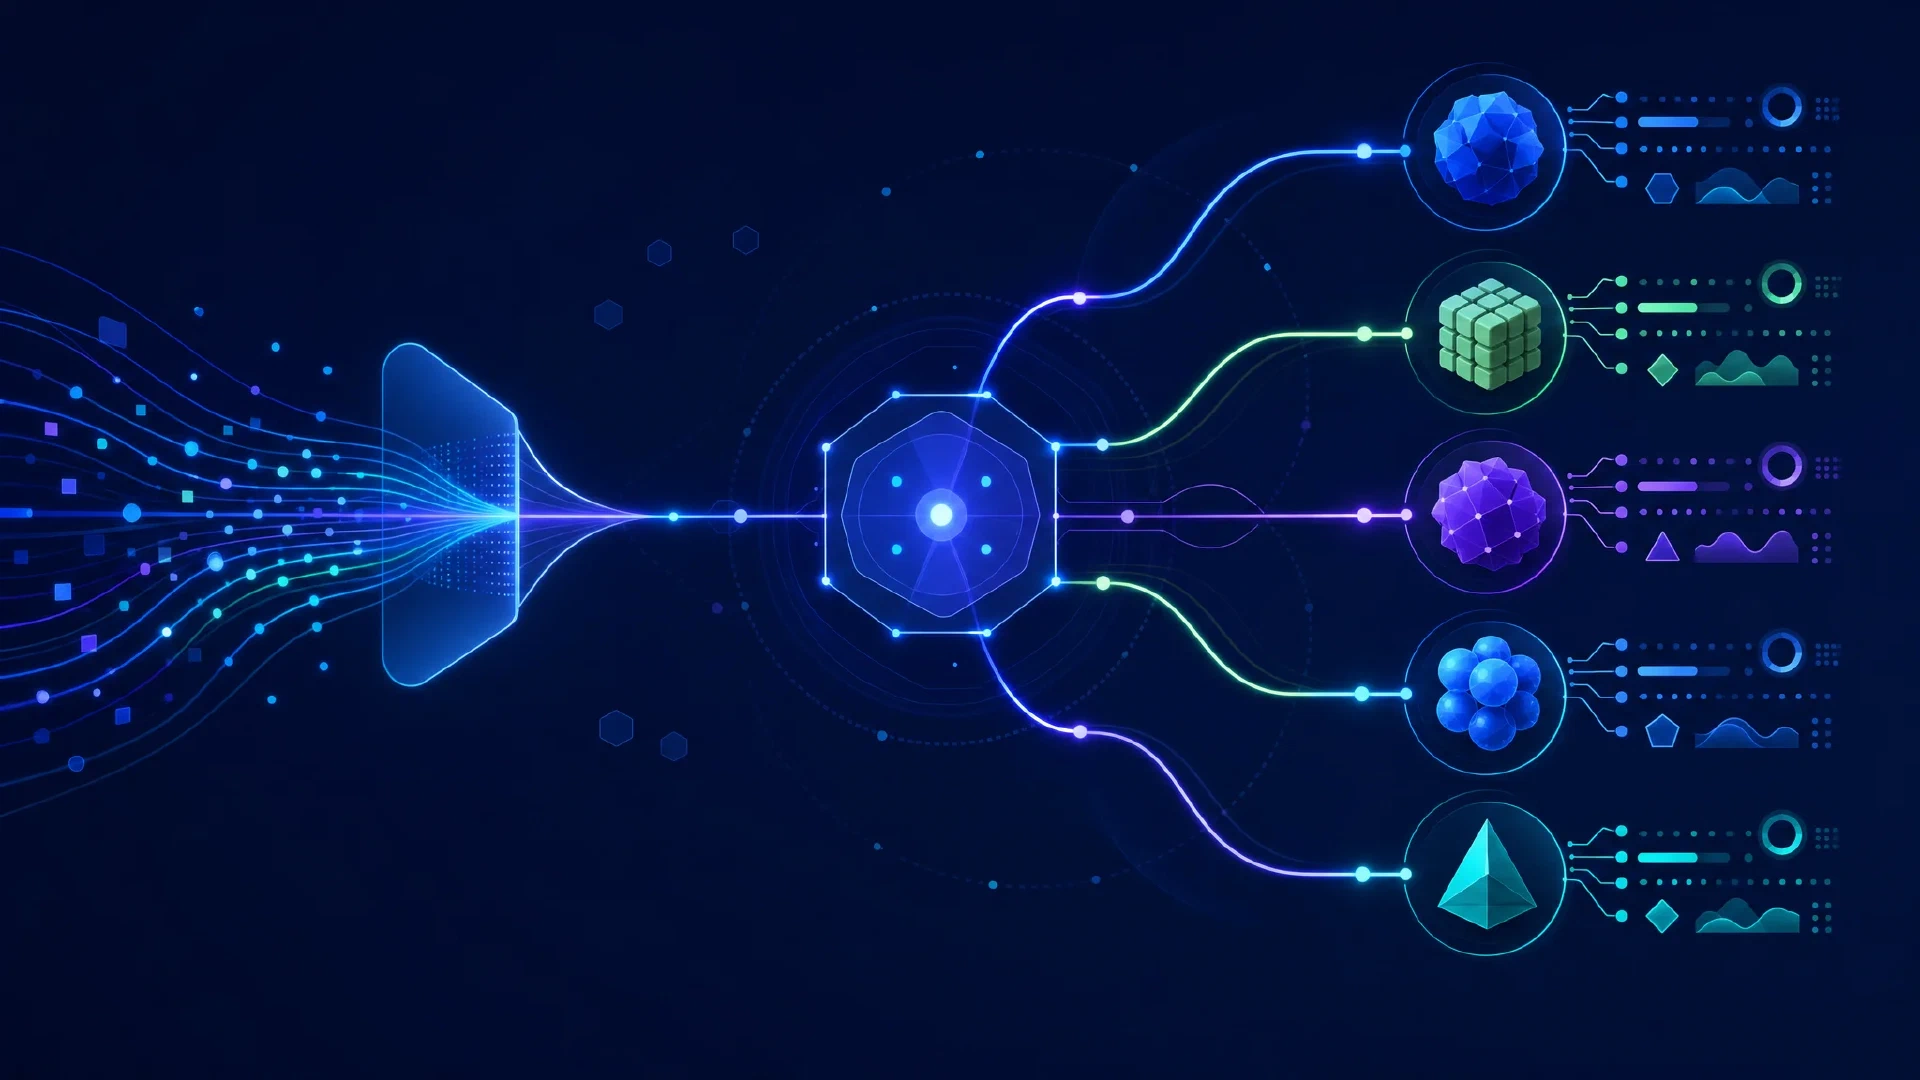
Table of Contents
Das OpenRouter-Provider-Routing bestimmt, welcher Inferenzdienst Ihre Anfrage beantwortet. Auch zwei Aufrufe mit demselben Modellnamen hängen von Endpoint-Limits, unterstützten Parametern, Serving-Software und Routing-Vorgaben ab. Werden Antworten kürzer oder schlagen Tool-Aufrufe fehl, prüfen Sie diese Unterschiede vor einer Schuldzuweisung an die Quantisierung.
Die wichtigsten Punkte
- Präzisionsbezeichnungen beschreiben ein Zahlenformat, keine Genauigkeitswertung.
- Endpoint-Limits bestimmen Kontext, Ausgabelänge und Funktionsunterstützung.
- Explizites Routing braucht neben einer Provider-Präferenz auch eine Fallback-Regel.
- Auto Exacto verbessert die Providerauswahl anhand von Qualitätssignalen und bietet eine Opt-in-Route für Anfragen ohne Tools.
- Effektive Kosten umfassen Ausgabe, Cache-Verhalten, Wiederholungen und erfolgreiche Aufgaben.
Voraussetzungen: Kenntnisse über JSON-Anfragen und Zugriff auf die OpenRouter-Konfiguration Ihrer Anwendung. Die Endpoint-Prüfung nutzt eine öffentliche API. Modellanfragen benötigen einen API-Schlüssel und verursachen Gebühren. Prüfen Sie Endpoint-Metadaten vor jedem datierten Beispiel erneut.
Zeit und Schwierigkeit: Etwa 20 Minuten für eine erste Konfigurationsprüfung. Mittelstufe. Ein brauchbarer Providervergleich braucht zusätzliche Tests mit repräsentativen Prompts.
Was Ihr Modellname auslässt
Eine Modellkennung wählt das angeforderte Modell. Der Provider betreibt den Inferenzdienst mit Modellimplementierung, Tokenlimits und Parser für Tool-Aufrufe. Ein Modellbenchmark prüft nicht jeden Dienst, der diese Gewichte hostet.
| Endpoint-Eigenschaft | Was zu prüfen ist |
|---|---|
| Kontextlänge | Platz für Prompt, Verlauf, Tool-Ergebnisse und Generierung |
| Maximale Completion-Länge | Ausgabelimit für die Aufgabe |
| Unterstützte Parameter | Tools, strukturierte Ausgabe, Sampling und Reasoning-Steuerung |
| Quantisierung | Gemeldetes Format im Vergleich zur Originalveröffentlichung |
| Preis | Input, Output, Cache-Lesen und zusätzliche Gebühren |
| Serving-Verhalten | Completion-Qualität, Parserfehler, Latenz und Wiederholungen |
Das Standard-Routing bevorzugt niedrigere Preise unter gesunden Kandidaten. OpenRouter beschreibt eine inverse quadratische Preisgewichtung. Im vereinfachten Beispiel erhält ein Kandidat für 1 Dollar neunmal das Auswahlgewicht eines Kandidaten für 3 Dollar. Das sind relative Gewichte, keine Garantie für die nächste Anfrage. Explizite Reihenfolge, Sortierung, Caching und Qualitätsrouting beeinflussen die Auswahl ebenfalls. Siehe die Dokumentation zum Provider-Routing .
Preisgewichtung beweist keine günstigste Rechnung für Ihr Workload. Das dokumentierte Beispiel legt kein universelles Input/Output-Verhältnis fest. Leiten Sie eine Auswahlwahrscheinlichkeit nicht allein aus dem Inputpreis ab.
Präzision im Kontext lesen
Quantisierung speichert Zahlenwerte mit einer reduzierten Darstellung. Die Wirkung hängt von Modell, Verfahren und Inferenzimplementierung ab. Niedrigere Präzision verlangt Tests. Das Label allein beweist keine Änderung der Originalgewichte durch einen Provider.
GPT-OSS liefert ein konkretes Beispiel. Die gpt-oss-120b-Dokumentation von OpenAI nennt MXFP4 für die Mixture-of-Experts-Gewichte und dieselbe Quantisierung für die Evaluierungen. Ein Vier-Bit-Label passt zu dieser Veröffentlichung. Es beweist keine zusätzliche Verschlechterung durch einen Provider.
Upcasting wandelt gespeicherte Werte in eine breitere Darstellung um. Die Umwandlung eines bereits quantisierten Checkpoints in BF16 stellt verworfene Informationen nicht wieder her. Die Umwandlung eines ursprünglich höher präzisen Checkpoints in vier Bits ist dagegen eine eigene Änderung, die geprüft werden sollte.
| Beobachtung | Gestützte Schlussfolgerung |
|---|---|
| Native MXFP4-Checkpoint | Vier-Bit-Expertengewichte gehören zur Veröffentlichung |
| BF16-Endpoint-Label | Breiter gemeldetes Format, kein Beweis besserer Antworten |
| Unbekannte Präzision | Fehlende Metadaten, kein Beweis versteckter Verschlechterung |
| Gleiche Präzisionslabels | Kein ausreichender Beleg für gleiches Serving-Verhalten |
Gleiche Labels schließen Quantisierungsunterschiede ebenfalls nicht aus. Sie nennen nicht, welche Tensoren quantisiert wurden, welche Kalibrierung galt oder welche Ausführungskernels laufen. Testen Sie den vollständigen Endpoint statt Bitbreite als Qualitätsrang zu behandeln.
Das Tokenbudget prüfen
curl --fail --silent --show-error \
  'https://openrouter.ai/api/v1/models/openai/gpt-oss-120b/endpoints' \
  | jq '.data.endpoints[] | {
      name,
      provider_name,
      context_length,
      max_completion_tokens,
      supported_parameters,
      quantization,
      pricing
    }'
Die Endpoint-API stellt Provider-Metadaten für ein Modell bereit. Der Befehl benötigt curl und jq. Prüfen Sie die
aktuelle gpt-oss-120b-Endpoint-Antwort
, bevor Sie einen Dienst auswählen. Behandeln Sie fehlende oder null-Werte als unbekannt, nicht als unbegrenzt. Speichern Sie für Vergleiche einen lokalen Snapshot mit Datum.
Eine Prüfung am 5. Oktober 2026 ergab diese beworbenen Limits für gpt-oss-120b. Es sind Metadaten, keine gemessenen Completion-Längen. Provider ändern sie über die Zeit.
| Provider | Kontexttokens | Maximale Completiontokens |
|---|---|---|
| DigitalOcean | 128,000 | 4,096 |
| Novita | 131,072 | 32,768 |
| Together | 131,072 | 117,964 |
Kontext- und Ausgabelänge sind getrennte Limits. Ein Modell mit langem Kontext braucht dennoch Platz für die Antwort. Gesprächsverlauf, Systemanweisungen und Tooldefinitionen verbrauchen gemeinsam mit dem Dokument Platz.
Reasoning-Tokens verbrauchen bei unterstützten Reasoning-Modellen ebenfalls das Generierungsbudget. Ein kleines Limit führt zu unvollständigem Reasoning, wenig sichtbarer Ausgabe oder einem Ende vor der finalen Antwort. Prüfen Sie Nutzung und Finish-Reason statt jede kurze Antwort schwächeren Gewichten zuzuschreiben. OpenRouter erklärt dies in der Dokumentation zu Reasoning-Tokens .
Ein explizites max_tokens gibt dem Router eine gewünschte Ausgabelänge für den Abgleich mit Provider-Support. Wählen Sie den Wert nach gemessenem Bedarf und verfügbarem Kontext. Ein zu hoher Wert verengt die Auswahl, garantiert aber keine längere oder bessere Antwort.
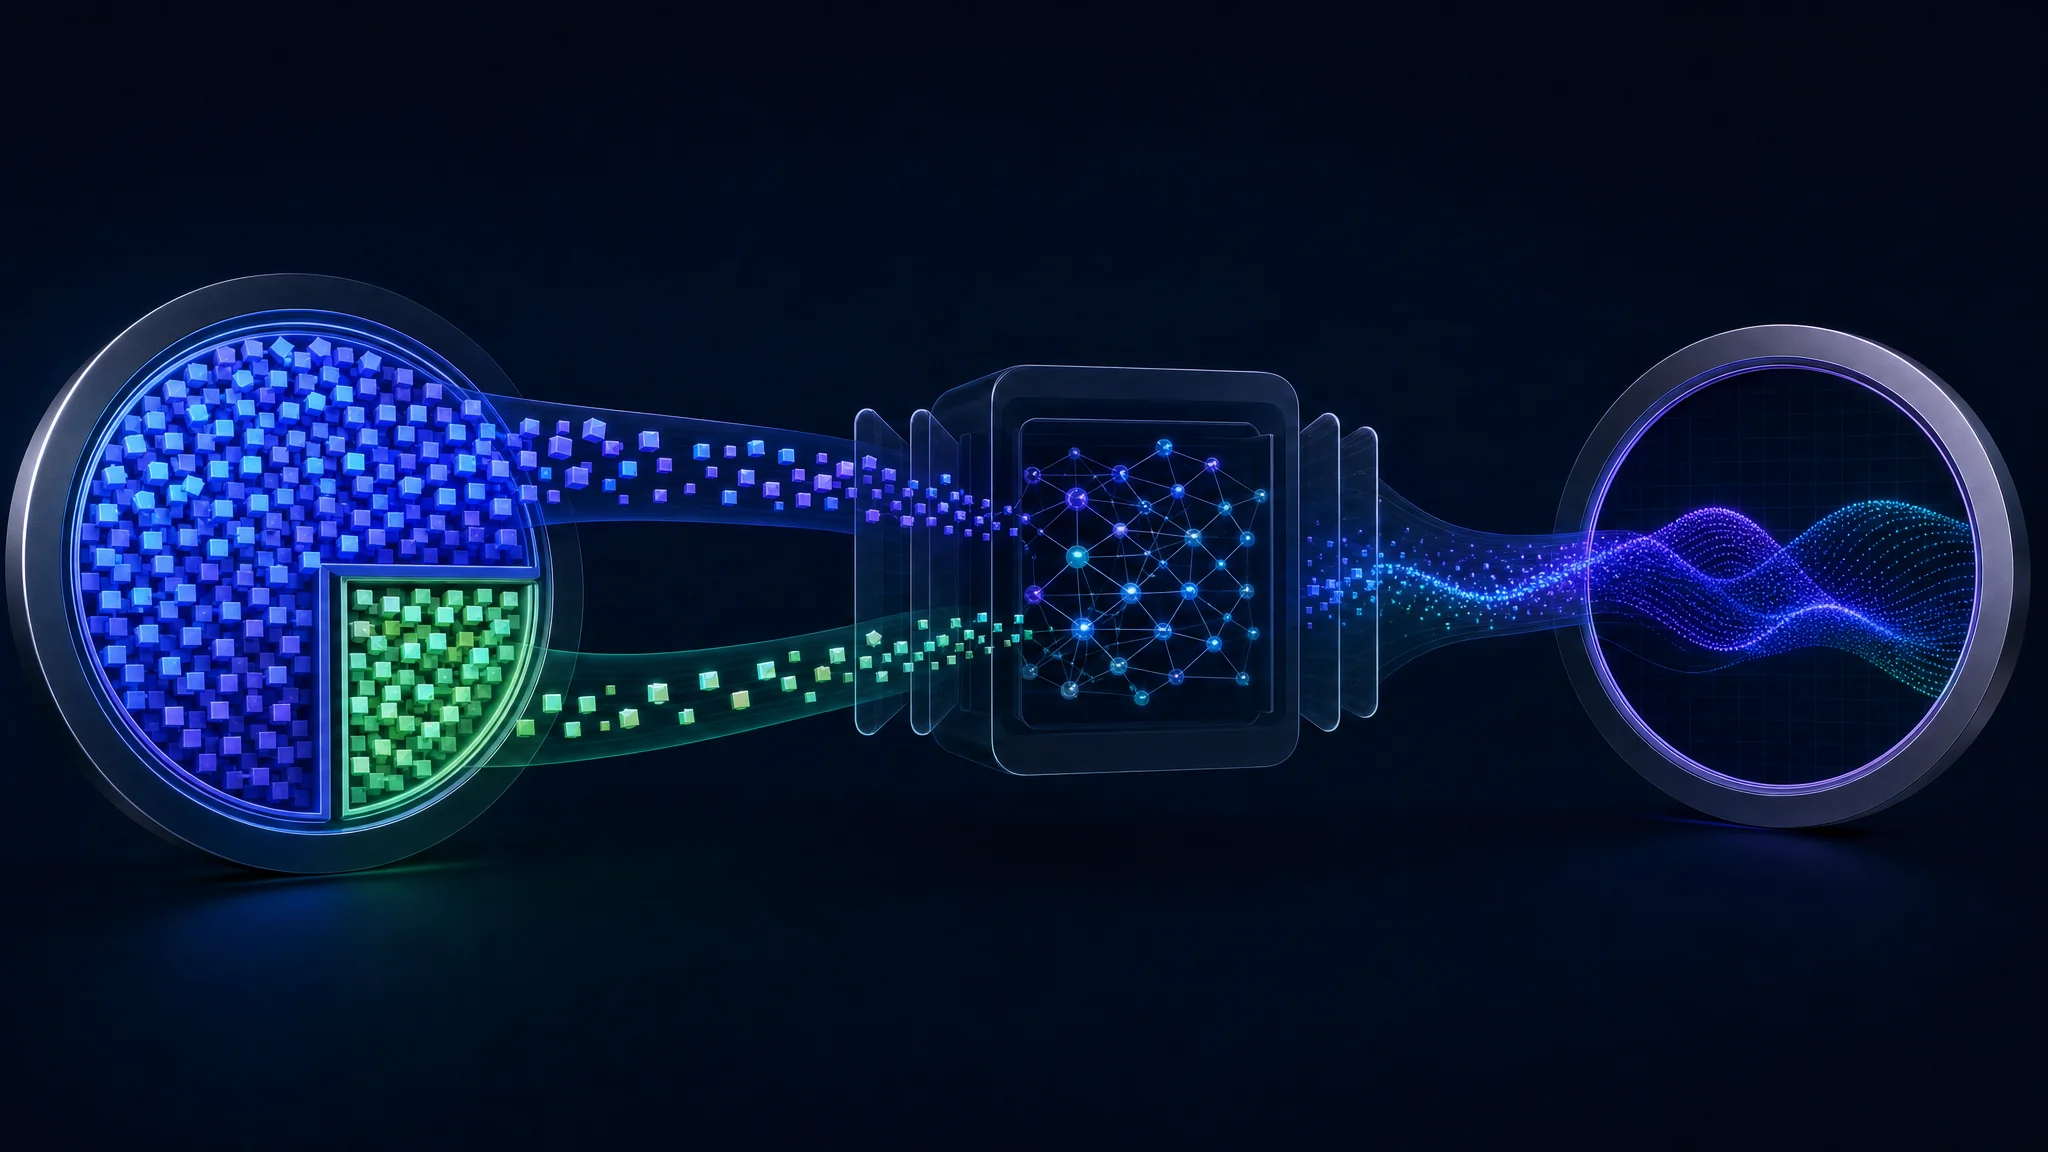
Conceptual token allocation, with reasoning and visible output sharing the completion allowance on supported providers
Ihre Parameter erzwingen
{
  "model": "openai/gpt-oss-120b",
  "messages": [
    {"role": "user", "content": "Explain the failure modes of a retry loop."}
  ],
  "max_tokens": 8192,
  "provider": {
    "require_parameters": true
  }
}
require_parameters ist standardmäßig false. Beim Standard-Routing schließen nicht unterstützte Parameter einen Endpoint nicht zwingend aus. OpenRouter dokumentiert, dass Provider unbekannte Parameter ignorieren. true filtert das Routing nach gemeldeter Unterstützung.
Support-Metadaten garantieren kein Verhalten. Ein Endpoint mit Seed-Support braucht Reproduzierbarkeitstests. Ein Tool-fähiger Endpoint braucht Schema-Validierung und Anwendungstests. Der Filter hält bekannte Inkompatibilitäten aus der Kandidatenmenge.
Provider bewusst festlegen
{
  "model": "openai/gpt-oss-120b",
  "messages": [
    {"role": "user", "content": "Summarize the supplied incident report."}
  ],
  "max_tokens": 8192,
  "provider": {
    "order": ["REPLACE_WITH_VERIFIED_PROVIDER_SLUG"],
    "allow_fallbacks": false,
    "require_parameters": true
  }
}
Ersetzen Sie den Platzhalter durch einen Provider-Slug aus der Modellliste. Senden Sie den Bericht in Ihrer echten Anfrage. Die Vorlage dient der Konfigurationsprüfung und ist erst nach dem Ersetzen ausführbar.
order setzt eine Präferenz. Allein lässt es Fallbacks zu anderen Providern aktiv. Kombinieren Sie es mit allow_fallbacks: false, um das Routing auf die aufgeführten Provider zu beschränken. Wenn keiner die Anfrage erfüllt oder verfügbar bleibt, schlägt die Anfrage fehl.
Endpoint-Varianten brauchen Aufmerksamkeit. Ein Basis-Provider-Slug passt nach den dokumentierten Regeln zu mehreren Varianten. Verwenden Sie beim Test einer bestimmten Dienstkonfiguration den genauen Variantenslug. Prüfen Sie den gemeldeten Provider für jede Antwort erneut.
quantizations ist eine Allowlist benannter Formate, kein numerisches Mindestmaß. Ein Array mit "fp8" wählt passende FP8-Endpoints. BF16 oder alle Formate mit mehr Bits werden nicht automatisch einbezogen. Vergleichen Sie zuerst den Originalcheckpoint und setzen Sie den Filter nur bei entsprechender Bewertung ein.
Qualitätsrouting aktiviert lassen
{
  "model": "openai/gpt-oss-120b:exacto",
  "messages": [
    {"role": "user", "content": "Compare the two supplied incident reports."}
  ],
  "max_tokens": 8192,
  "provider": {
    "require_parameters": true
  }
}
Auto Exacto nutzt Durchsatz, Tool-Telemetrie und Benchmarks, um leistungsschwache Provider zurückzustufen. Die Ankündigung von OpenRouter aus März 2026 berichtet 88 Prozent weniger GLM-5-Toolfehler, ungefähr von 8 auf 1 Prozent. Für gpt-oss-120b wird eine Änderung von 5,6 auf 3,5 Prozent berichtet.
Diese Werte stammen vom Anbieter und sind kein Versprechen für Ihre Anwendung. Tool-Call-Validität misst JSON, Namen und Schemas. Ein syntaktisch gültiger Aufruf braucht weiterhin richtige Argumente und die richtige Aktion.
Anfragen mit Tools erhalten Auto Exacto standardmäßig, wenn das Modell genügend Providerabdeckung hat. Für andere Anfragen aktiviert :exacto das Qualitätsrouting. Die aktuelle Dokumentation unterstützt Qualitätsrouting daher für Zusammenfassung und Chat ebenso wie für Tools.
sort: "price", der :floor-Suffix und ein kontoweiter Preis-Default umgehen Auto Exacto. Prüfen Sie App- und Kontoeinstellungen gemeinsam. Lesen Sie die
Auto-Exacto-Dokumentation
, bevor Sie Routingregeln kombinieren.
Workloadkosten berechnen
Der Inputpreis allein reicht für den Vergleich nicht. Diese Beispielpreise sind Dollar pro Million Tokens. Sie zeigen die Rechnung und sind keine aktuellen Providerangebote.
| Beispielendpoint | Inputpreis | Outputpreis |
|---|---|---|
| A | $0.03 | $16.00 |
| B | $0.42 | $1.32 |
Workload: 6 million input tokens + 1 million output tokens

A = 6 × $0.03 + 1 × $16.00 = $16.18
B = 6 × $0.42 + 1 × $1.32  =  $3.84

Per million combined input and output tokens:
A = $16.18 / 7 = $2.31
B =  $3.84 / 7 = $0.55
Endpoint A kostet für diese Mischung etwa 4,2-mal so viel trotz niedrigerem Inputpreis. Das Output/Input-Verhältnis von 533 zu 1 bei A vergleicht zwei Tarife. Es ist kein Multiplikator der Gesamtkosten. Andere Input/Output-Anteile ändern den Vergleich.
API-Preise verwenden andere Einheiten als Vergleichstabellen. Die Endpoint-API nennt Preise pro Token. Multiplizieren Sie mit einer Million, bevor Sie sie mit den obigen Sätzen vergleichen.
Prompt-Caching fügt eine weitere Variable hinzu. Cache-Lesen, Cache-Schreiben und nicht gecachter Input brauchen nach den Providerregeln eigene Abrechnung. Wiederholter Text garantiert keinen Cache-Treffer. Prüfen Sie gemeldete Cachetokens und Kosten in der Dokumentation zum Prompt-Caching .
Routing beeinflusst die Cache-Kontinuität. OpenRouter dokumentiert Sticky Routing für Caching, während manuelle Providerreihenfolge Vorrang hat. Auto Exacto ordnet Provider ebenfalls neu und unterbricht manchmal einen warmen Cache. Vergleichen Sie Cacheersparnis mit Qualitäts- und Wiederholungskosten, bevor Sie eine Regel ändern.
Kosten pro akzeptiertem Ergebnis sind die nützliche Anwendungsmetrik. Teilen Sie alle Ausgaben einschließlich fehlgeschlagener Wiederholungen durch Ergebnisse, die Ihre Akzeptanzkriterien erfüllen. Nicht tokenbasierte Gebühren führen Sie getrennt auf. Ein niedriger Tokensatz rettet wiederholt erfolglose Aufgaben nicht.
Eine uneinheitliche Antwort analysieren
| Symptom | Erste Prüfung |
|---|---|
| Kurze oder unvollständige Antwort | Finish-Reason, Ausgabelimit, Reasoning-Nutzung |
| Fehlende Dokumentdetails | Gesendeter Inhalt, Endpoint-Kontextlimit, Clientkürzung |
| Fehlerhafter Tool-Aufruf | Beworbener Support, Toolschema, Parsing-Verhalten |
| Anderes Sampling-Verhalten | Angeforderte Parameter und gemeldeter Support |
| Unerwartete Kosten | Ausgabevolumen, Cache-Lesen, Wiederholungen, Providerwechsel |
| Kein berechtigter Provider | Widersprüchliche Limits, Allowlists, Fallbacksperren |
Bewahren Sie die Generierungs-ID, die mit der Antwort zurückkommt. Die API für Generierungsmetadaten stellt Provider, Nutzung, Kosten und Finish-Informationen bereit. Eine Session-ID gruppiert zusammengehörige Arbeit, ersetzt aber nicht die Generierungs-ID für eine einzelne Anfrage.
Speichern Sie die Anfrage neben der Generierungs-ID. Halten Sie Modell, Providerpräferenzen, angeforderte Parameter, Zeitstempel und Antwortnutzung zusammen. So bleibt ein späterer Qualitäts- oder Kostenvergleich reproduzierbar, wenn Routing, Preise oder Endpoint-Metadaten wechseln.
Vergleichen Sie Endpoints unter gleichen Bedingungen. Nutzen Sie denselben Prompt, dieselben Tools, Reasoning-Einstellungen und dasselbe Tokenbudget. Wiederholen Sie den Test mit mehreren repräsentativen Aufgaben. Trennen Sie unvollständige Antworten, ungültige Tool-Aufrufe und falsche Antworten, statt eine unerklärte Gesamtwertung zu bilden.
Benchmarkunsicherheit zählt. Die Analyse von Epoch AI beschreibt Unterschiede durch Implementierungen, Sampling und Agentengerüste. Eine enttäuschende Antwort beweist weder einen dauerhaften Providerfehler noch seine Ursache.
Endpoint-Routing im Ablauf
Weiterführendes Video: Diskussion zu OpenRouter-Endpointqualität und Routing . Prüfen Sie Endpointlisten erneut, bevor Sie konkrete Preise, Limits oder Providervergleiche anwenden.
Nächste Schritte
- Endpoints eines Modells prüfen und die für Ihren Workload wichtigen Limits notieren.
- Eine Routingregel wählen mit expliziten Parameteranforderungen und Fallback-Verhalten.
- Repräsentative Aufgaben testen gegen Kandidaten-Endpoints und Qualitätsrouting.
- Kosten akzeptierter Ergebnisse erfassen zusammen mit Latenz, Cache-Nutzung und Fehlerkategorien.
- Nach Änderungen erneut prüfen, etwa bei Modellversionen, Serving-Verhalten oder Providerpreisen.
Für weitere KI-Grundlagen lesen Sie Grundlegende KI-Konzepte . Für Agentenberechtigungen und Validierungskontrollen lesen Sie KI-Systeme absichern .
Related Posts