Reichen 16GB VRAM für ernsthafte lokale LLM-Arbeit?
Table of Contents
16GB dedizierter GPU-Speicher reichen für ernsthafte lokale LLM-Arbeit, wenn Modell, Kontext und Runtime zusammenpassen. Das Laden der Gewichte erfüllt nur die erste Voraussetzung. Ein brauchbares System braucht auch genug Speicher für die laufende Unterhaltung und genug Geschwindigkeit für deine Aufgabe.
Nutze Qwen3.8 27B als Beispiel für das Budget eines Coding- oder Dokumenten-Workflows mit einem Benutzer. Beginne mit dem benötigten Kontext. Wähle danach Gewichte und Runtime-Einstellungen, die in den verbleibenden Speicher passen. Hardwarespezifikationen und Modellquellen wurden am 7. Oktober 2026 geprüft.
Wichtigste Punkte
- Reserviere Speicher für den Kontext, bevor du eine Quantisierung auswählst.
- Miss die Prompt-Verarbeitung getrennt von der Ausgabegeschwindigkeit.
- Deaktiviere ungenutzte Vision-Unterstützung und teste einen 8-Bit-KV-Cache.
- Vergleiche die genaue GPU, das Backend, die Modelldatei und die Prompt-Länge.
- Berechne die Einsparung gegenüber dem Hosting anhand deiner Arbeitslast und Providerrechnung.
Für die Budgetübung brauchst du das Speicherprotokoll der Runtime, den exakten Dateinamen des Modells und eine typische Aufgabe. Plane etwa 20 Minuten für Einrichtung und Aufzeichnung ein, zusätzlich zur Inferenzzeit. Der Schwierigkeitsgrad ist mittel.
Speicher an die Arbeit anpassen
16GB passen zu einer Arbeitslast, deren Gewichte, aktiver Kontext und temporäre Zuweisungen in den verfügbaren GPU-Speicher passen. Der benötigte Kontext hängt von der Aufgabe ab. Eine kurze Dokumentzusammenfassung und ein Coding-Agent mit Dutzenden Dateien brauchen unterschiedliche Budgets.
| Arbeitslast | Erste Frage zur Dimensionierung |
|---|---|
| Kurzer Chat oder Entwurf | Erreicht das Modell dein Qualitätsziel? |
| Dokumentenanalyse | Passen Quelltext und Antwort zusammen? |
| Coding-Agent | Wie viel Kontext verbrauchen Dateien und Tool-Ergebnisse? |
| Parallele Anfragen | Wie viel Cache braucht jede aktive Sitzung? |
Ein konfiguriertes Fenster unterscheidet sich von einem belegten Fenster. Ein Benchmark mit 64K-Limit und kurzem Prompt misst keine Generierung nach 55K Gesprächstokens. Teste nahe an der erwarteten Sitzungsgröße, bevor du Hardware auswählst.
Warum das Modell passt
Quantisierung speichert Gewichte mit weniger Bits. Bartowskis Qwen3.8-27B-Dateitabelle führt Q4_K_M mit 17.44 GB auf. Das liegt bereits über den etwa 17.18 Milliarden Bytes eines 16-GiB-Geräts, noch ohne Runtime-Speicher.
Die GSQ-RCO-Modelkarte von ISTA-DASLab führt IQ3_S mit 11.8 GB auf. Die Methode weist verschiedenen Tensoren innerhalb eines Größenbudgets unterschiedliche Präzision zu. Die optionale MTP-Version fügt etwa 0.35 GB hinzu, der Vision-Projektor etwa 0.9 GB.
| Veröffentlichtes Benchmark | BF16 / IQ3_S-Wert |
|---|---|
| AIME25 | 100.00 / 100.00 |
| LiveCodeBench v6 | 85.71 / 85.71 |
| GPQA-Diamond | 89.90 / 89.39 |
Das Labor nennt diesen Betriebspunkt „task-lossless“. Die ausgewählten Ergebnisse stützen einen engen Vergleich. Sie beweisen keine identischen Antworten, keine gleiche Suche in langem Kontext und keine gleiche Zuverlässigkeit bei deinen Coding-Aufgaben. Teste das komprimierte Modell anhand deiner eigenen Abnahmekriterien.
Cache berechnen
Der KV-Cache speichert Attention-Schlüssel und -Werte bereits verarbeiteter Tokens. Prompt, Tool-Ausgabe und erzeugte Antworten verbrauchen Kontext. Manche Runtimes reservieren die Cache-Kapazität beim Start. Der angezeigte Speicher muss daher nicht mit jeder Nachricht wachsen.
Qwens Konfiguration nennt 64 Layer, vollständige Attention in jedem vierten Layer, vier KV-Heads und eine Head-Dimension von 256. Für die 16 Layer mit vollständiger Attention betragen die berechneten FP16-Kosten:
16 layers × 4 KV heads × 256 elements × 2 (K and V) × 2 bytes
= 65,536 bytes per token
= 64 KiB per token
Die Rechnung schließt rekurrenten Zustand, Alignment, temporäre Buffer und Zuweisungen für speculative decoding aus. Andere Architekturen brauchen andere Rechnungen.
| Belegte Tokens | FP16-Cache für vollständige Attention |
|---|---|
| 32,768 | 2 GiB |
| 65,536 | 4 GiB |
| 131,072 | 8 GiB |
| 262,144 | 16 GiB |
KiB und GiB verwenden hier Potenzen von 1024. Downloadgrößen der Modelle verwenden dezimale GB. Gemischte Einheiten verfälschen das verbleibende Budget.
Verfügbaren Kontext budgetieren
Zwei Einstellungen schaffen Speicher für längere Textsitzungen: Entferne einen ungenutzten Vision-Projektor und senke die Cache-Präzision. Berechne den Effekt gegenüber dem geladenen Modell und den Runtime-Zuweisungen.
Nutze dieses Beispiel mit dezimalen GB für jede Zuweisung. Die Reserve von 1.0 GB ist eine Planungsannahme, kein allgemeiner Runtime-Standard.
| Zuweisung | Vision an / Vision aus |
|---|---|
| Physische Kapazität 16 GiB | 17.180 / 17.180 GB |
| Modellgewichte | 11.800 / 11.800 GB |
| Optionaler MTP-Head | 0.350 / 0.350 GB |
| Geschätzter Vision-Projektor | 0.930 / 0 GB |
| Angenommene sonstige Zuweisungen | 1.000 / 1.000 GB |
| Für wachsenden Cache verfügbar | 3.100 / 4.030 GB |
Bei 65,536 Bytes pro Token enthalten 3.100 GB etwa 47,300 Tokens. Ohne Vision würden ideale 8-Bit-Daten 32,768 Bytes pro Token nutzen und etwa 123,000 Tokens aufnehmen.
Echter q8_0-Speicher enthält Block-Skalierungen. Bei 34 Bytes je 32 Werte braucht dieses Beispiel etwa 34,816 Bytes pro Token. Die Schätzung sinkt dadurch auf ungefähr 115,700. Weitere Zuweisungen senken das Ergebnis. Rund 110K sind unter diesen Annahmen daher eine plausible Planung, keine garantierte Einstellung.
Der verbleibende Kontext muss Eingabe und Ausgabe abdecken. Bei einem Fenster von 65,536 Tokens lassen ein beispielhafter 30,000-Token-Startprompt und 8,192 Tokens Ausgabe 27,344 Tokens für Dateien, Tool-Ergebnisse und Unterhaltung. Das Startbudget ist ein Beispiel. Miss deine Tools und Anweisungen.
Einstellungen zum Testen
Die llama.cpp-Serverdokumentation beschreibt getrennte Schlüssel- und Wert-Cachetypen, automatisches Laden des Projektors und parallele Slots. Teste für Text-only die deaktivierte Vision, q8_0 für beide Cachetypen und einen Slot. Beginne mit einem moderaten Kontext.
Protokolliere die Zuweisungen, bevor du den Kontext erhöhst. Cache-Quantisierung braucht Unterstützung durch Architektur und Backend. Teste die Antwortqualität nach einer Änderung der Präzision. Bewahre eine funktionierende Konfiguration zum Vergleich auf.
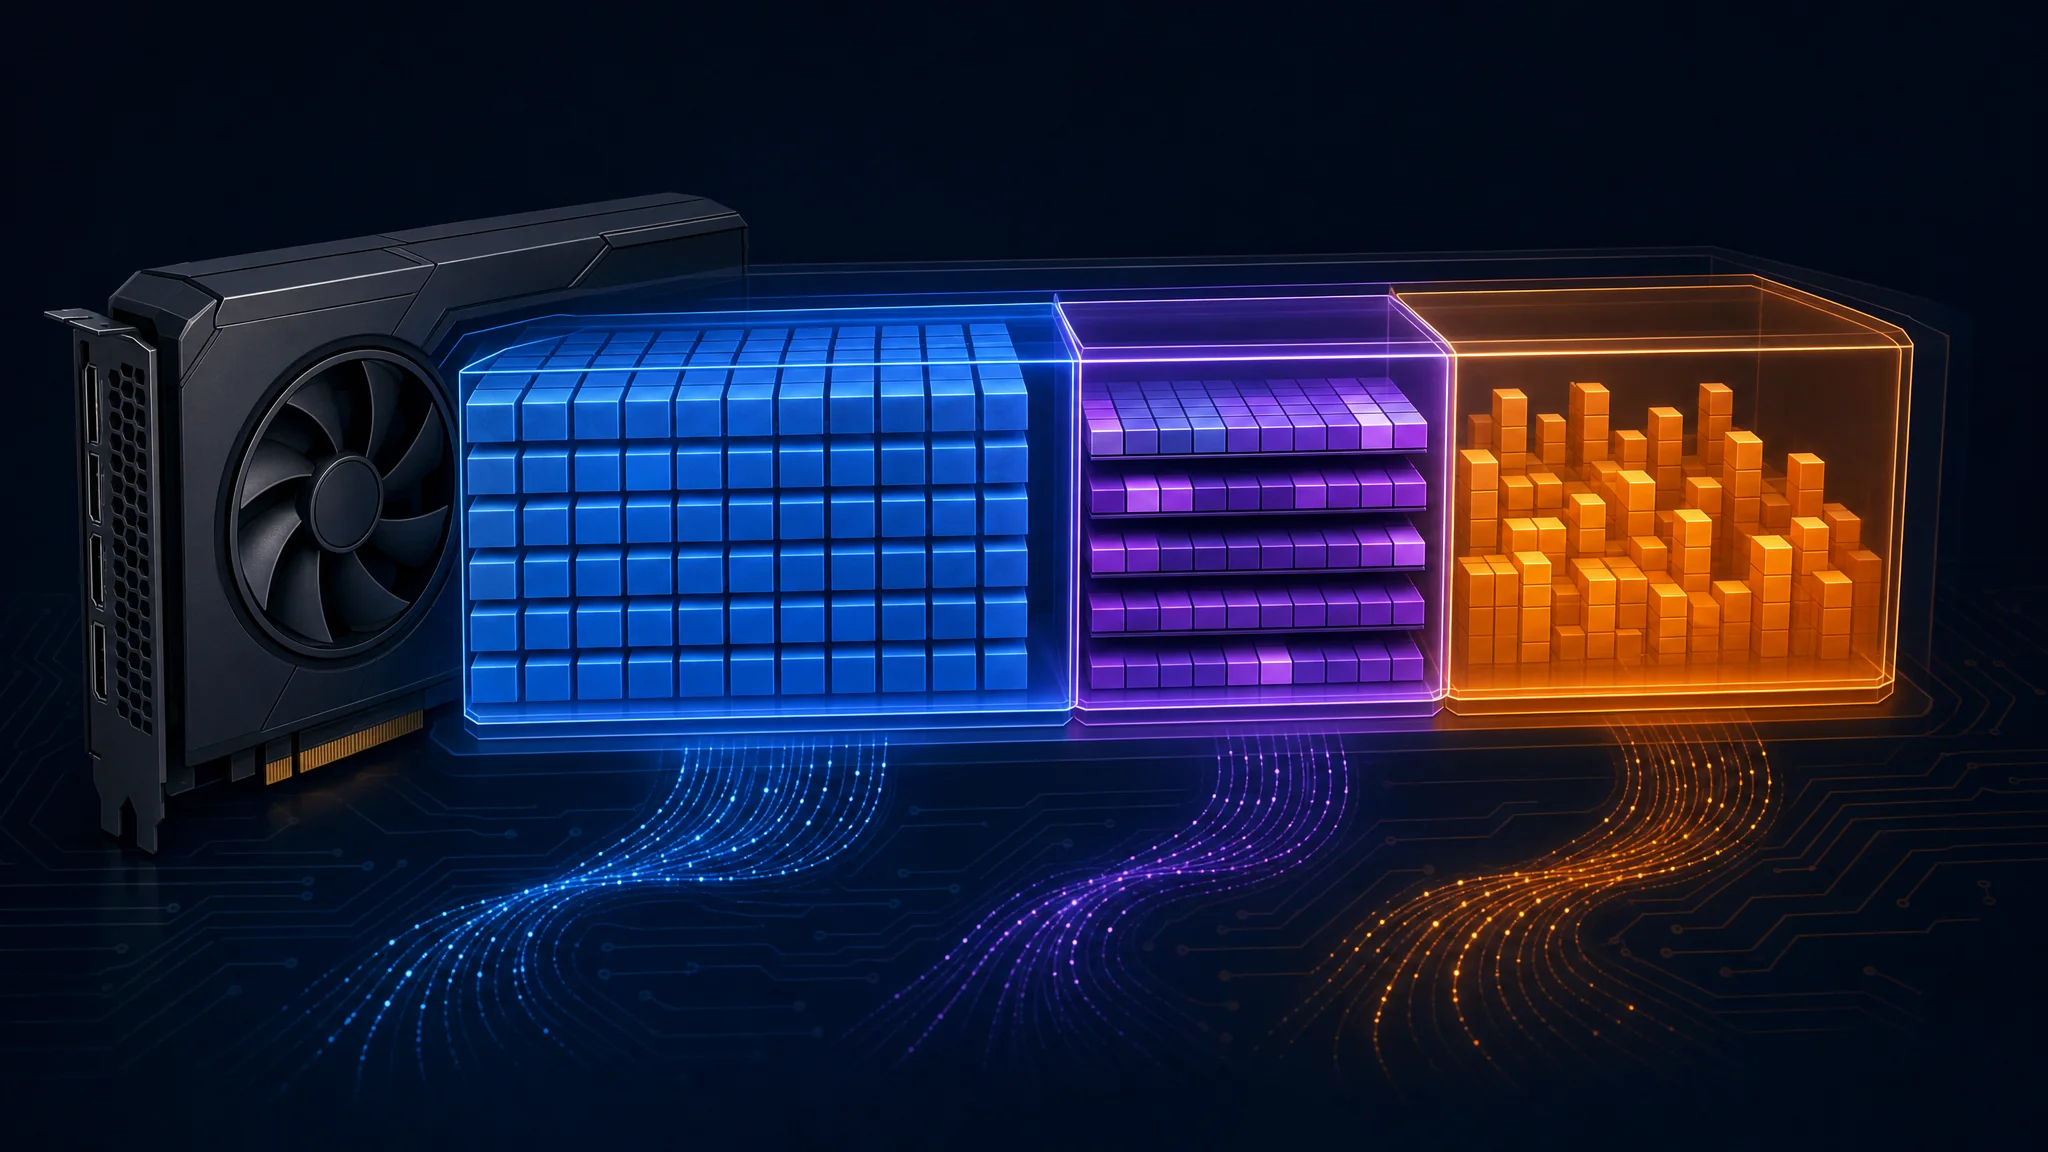
Blau steht für Gewichte, Violett für Kontext-Cache und Orange für Runtime-Zuweisungen. Die Größen sind beispielhaft
Warum Geschwindigkeiten abweichen
Eine 16GB-Angabe beschreibt die Kapazität. Der Durchsatz hängt auch von Speicherbandbreite, Rechenkernels, aktivem Kontext, Offload, Batching und speculative decoding ab.
| Ursache | Was prüfen |
|---|---|
| CPU- oder RAM-Offload | Platzierung geladener Layer und Cache-Ort |
| Langer Kontext | Belegte Tokens während der Messung |
| Backend-Unterschiede | Runtime-Commit, Treiber und Kernelpfad |
| Speculative decoding | Akzeptierte Entwürfe und zusätzliche Zuweisungen |
Bei einem dichten Modell, das jeweils einen Token erzeugt, ergibt Speicherbandbreite geteilt durch residente Gewichtsbytes eine grobe Schätzung nur aus der Bandbreite. Bei 448 GB/s und 11.8 GB Gewichten sind es etwa 38 Tokens pro Sekunde. Cache-Lesevorgänge und Berechnung erhöhen die Arbeit. Speculative decoding und Batching ändern die Annahmen.
Behandle diesen Quotienten nicht als allgemeine Obergrenze. Eine höhere Ausgaberate widerlegt einen Benchmark nicht automatisch. Prüfe, ob ein Durchlauf des Zielmodells mehrere Entwurfstokens akzeptiert hat.
Multi-Token Prediction, kurz MTP, braucht ein kompatibles Modell und eine kompatible Runtime. Vergleiche aktivierte und deaktivierte Läufe bei kurzem und langem belegtem Kontext. Zusätzliche Gewichte und Entwurfszustand verbrauchen Speicher. Keine allgemeine Regel verlangt, MTP nach 32K Tokens zu deaktivieren.
Erste Antwort messen
Prefill verarbeitet den Prompt vor der Generierung. Decode erzeugt die Antwort. Ein schnelles Decode-Ergebnis verdeckt eine langsame erste Antwort, wenn die Aufgabe mit einem großen, nicht gecachten Prompt beginnt.
Teile nicht gecachte Prompt-Tokens durch den gemessenen Prefill-Durchsatz. So schätzt du die Verarbeitungszeit. Für einen neuen Prompt mit 30,000 Tokens ergeben zwei Beispielraten diese Wartezeiten:
| Beispielrate des Prompts | Berechnete Verarbeitungszeit |
|---|---|
| 750 Tokens/s | 40 Sekunden |
| 150 Tokens/s | 200 Sekunden |
Die Beispiele beschreiben die Verarbeitungszeit ohne Modellladen und Anfrage-Overhead. Prompt-Länge, Batch-Größe, Modellformat und Backend beeinflussen die Messung.
Miss eine kalte Anfrage und eine Fortsetzung mit wiederverwendbarem Präfix getrennt. Präfix-Wiederverwendung vermeidet die Verarbeitung wiederholter Eingabe. Protokolliere die Zeit bis zum ersten Token neben Decode-Rate und Gesamtdauer.
Vollständige GPU-Systeme vergleichen
Vergleiche Kaufpreis, nutzbaren Speicher, Bandbreite und Softwarepfad gemeinsam. Eine billigere Karte verliert ihren Vorteil, wenn deine Arbeitslast nicht unterstützte Funktionen braucht oder länger als dein Latenzziel dauert.
| Desktopkarte mit 16GB | Speicherbandbreite |
|---|---|
| RX 9060 XT | 320 GB/s |
| RTX 5060 Ti | 448 GB/s |
| RX 9070 | 640 GB/s |
| RX 9070 XT | 640 GB/s |
Die RX-9070-Spezifikationen von AMD und die RX-9070-XT-Spezifikationen bestätigen 16GB und bis zu 640 GB/s. Der Vergleich 640 zu 448 ergibt etwa 43% mehr theoretische Bandbreite. Daraus folgt keine 43% höhere Inferenzleistung.
Wähle Benchmarks mit deinem Modell und Backend. Bei kurzen Prompts und dauerhafter Generierung zählt Decode-Leistung stärker. Bei Repository-Analyse zählen kaltes Prefill, Langkontext-Geschwindigkeit und erfolgreiche Aufgabenbearbeitung. Prüfe die Software vor dem Kauf.
Mac- und Laptop-Angaben
Ein 16GB-Mac mit Apple silicon teilt den Speicher zwischen CPU, GPU, Betriebssystem und Anwendungen. Eine separate 16GB-GPU besitzt dedizierten Videospeicher zusätzlich zum Systemspeicher. Diese Kapazitäten bedeuten keine gleich großen Modellbudgets.
Apple stellt eine empfohlene GPU-Working-Set-Größe bereit. Prüfe den von deiner Runtime gemeldeten Wert und den Speicherdruck des Systems. Lass Platz für macOS und andere Anwendungen.
Bei Laptops prüfst du die exakte SKU, den dedizierten Speicher, das GPU-Power-Limit und die Kühlung. Die RTX-5060-Familienseite von NVIDIA nennt Desktop-Speichervarianten der RTX 5060 Ti. Ein Familienname beweist keine 16GB. Desktop-Ergebnisse beweisen keinen Laptop-Durchsatz.
Lohnt sich der Besitz?
Finanziell lohnt sich der Besitz, wenn vermiedene Hostingkosten die Betriebskosten übersteigen und den Hardwarekauf zurückzahlen. Beginne mit einem reinen Ausgabe-Beispiel: $789 für die Karte, 35 Ausgabetokens/s, 180W während der Generierung, $0.18/kWh Strom und $2.95 je Million gehosteter Ausgabetokens. Die Werte dienen als Beispiel. Ersetze sie durch dein Angebot, gemessene Leistung, Stromtarif und Providerpreise.
Hours per million output tokens = 1,000,000 ÷ 35 ÷ 3,600 = 7.94
Electricity per million = 7.94 × 0.180 kW × $0.18/kWh = $0.257
Savings per million = $2.95 - $0.257 = $2.693
Break-even output = $789 ÷ $2.693 = 293 million tokens
Continuous generation time = 293 × 7.94 ÷ 24 = about 97 days
Bei acht Stunden ununterbrochener Generierung pro Tag dauert dieselbe Rechnung etwa 291 Tage. Acht Stunden mit geöffnetem Assistenten sind nicht dasselbe wie acht Stunden Token-Generierung.
Bei einem Hostingpreis von $0.16 je Million kostet der lokale Strom in diesem Szenario bereits mehr als Hosting. Unter diesen Annahmen gibt es keinen positiven Break-even nur für die Ausgabe.
Nutze die aktuellen OpenRouter-Modellpreise des gewählten Providers, einschließlich Eingabe- und Cached-Input-Gebühren. Miss die Energie des Gesamtsystems einschließlich Prefill. Addiere Upgrades, Leerlaufenergie, Wartung und erwarteten Wiederverkaufswert. Vergleiche angenommene Arbeit, denn Wiederholungen und Qualitätsunterschiede verändern die Kosten je Aufgabe.
Wann mehr Speicher nötig ist
Gehe über 16GB hinaus, wenn deine gemessene Arbeitslast den verfügbaren Kontext bei akzeptabler Qualität und Latenz überschreitet. Lange tägliche Agentensitzungen, parallele Anfragen und höher präzise Gewichte sprechen für mehr Kapazität.
Zwei 16GB-Karten brauchen ausdrückliche Runtime-Unterstützung. Sie werden nicht zu einer transparenten 32GB-Zuweisung. Jedes Gerät braucht Buffer. Die Kommunikation nutzt die Verbindung des Hosts.
| Aufteilung | Wichtigster Nachteil |
|---|---|
| Layer-Aufteilung | Verschiedene Layer liegen auf verschiedenen Geräten |
| Tensor- oder Zeilen-Aufteilung | Arbeit innerhalb der Layer erzeugt Kommunikation |
| CPU plus GPU | Mehr Kapazität mit anderem Latenzprofil |
Ziehe eine zweite Karte in Betracht, wenn Mainboard, Netzteil, Kühlung und Backend den Plan unterstützen. Vergleiche die Systemkosten mit einer einzelnen größeren GPU. Der Qwen-Hardwareleitfaden für 32GB behandelt diese Alternativen.
Fehlerbehebung und nächste Schritte
Wenn das Laden fehlschlägt, senke den Kontext und prüfe die Zuweisungen. Wenn die Geschwindigkeit während einer Sitzung sinkt, prüfe belegten Kontext und CPU-Offload. Wenn die erste Antwort stockt, miss kaltes Prefill. Wenn Tool-Nutzung nach Kompression scheitert, vergleiche dieselbe Aufgabe mit einem höher präzisen Modell.
Speichere einen wiederholbaren Test mit deinen normalen Anweisungen, Dateien und Tool-Ausgaben. Notiere Modellrevision, Runtime-Version, Cache-Präzision, belegten Kontext, Spitzenverbrauch, First-Token-Latenz, Decode-Geschwindigkeit und den Aufgabenerfolg. Wiederhole den Test nahe an der längsten erwarteten Sitzung.
Nutze den Leitfaden zu lokalen Modellen und Kontext , um kleinere Alternativen zu vergleichen. Wähle das kleinste Modell, das deine Qualitätsanforderungen erfüllt, und reserviere genug Speicher für die vollständige Aufgabe. Unter diesen Bedingungen sind 16GB ein brauchbares Workstation-Ziel.
Related Posts