Einblick in unsere hybride KI-Agentenflotte: Hermes, LiteLLM und Tailscale

Table of Contents
Wir haben eine lokale GPU-Flotte mit auftragsbezogener Zuweisung bereitgestellt und ihre hybride Steuerungsebene entworfen. Der verifizierte Pfad beginnt bei LiteLLM, wählt eine Modellgruppe aus und lädt jeweils ein lokales Modell auf eine GPU. Die Hermes-Stufenrichtlinie ist vorgeschlagen. Ein Konfigurationsartefakt für Tailscale Aperture ist für den nächsten Integrationstest bereit. Ein gemeinsamer End-to-End-Pfad wurde für keines von beiden verifiziert.
Inaktive Grafikkarten minen Pearl. Eine KI-Anfrage pausiert das Mining nur auf der ausgeliehenen Karte, bearbeitet die Anfrage, entlädt das Modell und gibt die Karte an den Miner zurück.
Wichtigste Erkenntnisse
- T0 bis T2 übernehmen aufwendige oder anspruchsvolle Arbeit. Diese Routen bevorzugen gehostete Spitzenmodelle und geordnete Ausweichketten.
- T3 übernimmt umfangreiche lokale Arbeit. Die Flotte weist Planung, Programmierung, Prüfung und Vision Modellen mit 4B bis 12B Parametern zu.
- T4 übernimmt häufige lokale Aufgaben. Kleine Modelle routen, klassifizieren, extrahieren, erstellen Embeddings und erledigen klar begrenzte Codeaufgaben.
- Jede GPU ist eine unabhängige Ressource. Eine Karte bedient KI, während die übrigen weiter minen.
- Lokale Modelle bleiben im Leerlauf entladen. Zwischen Anfragefenstern belegt kein Modell GPU-Speicher.
- Jedes Gateway stellt denselben logischen Katalog bereit. Gemeinsame Aliase verteilen Arbeit auf geeignete Systeme. Aliase mit Knotenpräfix sichern bei Bedarf eine genaue Zuordnung.
- Der experimentelle Broker ging nicht in Produktion. Sein Canary bediente eine Anfrage, scheiterte dann aber an einem Test zum sauberen Herunterfahren. LiteLLM blieb auf dem verifizierten anfragebezogenen Pfad.
- Hermes und Aperture sind noch vorbereitet. Das Zieldesign liegt vor, die End-to-End-Abnahme ist offen.
Voraussetzungen: mehrere Linux-GPU-Hosts, stabile NVIDIA-Treiber, ein Tailscale-Tailnet, systemd, ein funktionierender Miner, Modellspeicher und Abnahmetests für jede Modellroute.
Zeit und Schwierigkeitsgrad: Fortgeschritten. Plane mehrere Tage für Inventar, Modelldownloads, Diensteinheiten, Routingtests, Fehlerübungen und Prüfungen zur Wiederherstellung des Minings pro Karte ein.
Begriffe in diesem Artikel: Ein Tailnet ist das private Netz aus Tailscale-Identitäten und Geräten. Ein Modellalias ist ein stabiler Modellname, den Clients sehen. Eine Modellgruppe fasst mehrere Bereitstellungen unter einem Alias zusammen. Ein Pool-Proxy ist ein kleiner lokaler Dienst, der eine GPU ausleiht, den Modellprozess startet und die Karte anschließend an das Mining zurückgibt.
Das Designziel
Agentenaufgaben sehen sehr unterschiedlich aus. Eine Reparatur in einem Repository braucht ein anderes Modell als ein Titel, ein Screenshot, ein Embedding oder eine Absichtsklassifizierung. Jede Anfrage an das größte Modell zu senden, verschwendet Geld und lokale Kapazität. Jede Anfrage an das kleinste Modell zu senden, erzeugt Wiederholungen und schwache Ergebnisse.
Wir wollten einen Katalog mit fünf Arbeitsstufen. Die Richtlinie sollte gehostete und lokale Modelle über vertraute API-Formate bedienen. Lokale GPUs sollten zwischen KI-Anfragen weiterarbeiten.
Die Flotte sollte außerdem parallele Arbeit ermöglichen. Ein Host mit mehreren Karten sollte mehrere unabhängige Aufgaben gleichzeitig bedienen. Eine Anfrage auf einer Karte sollte das Mining auf den übrigen Karten im Gehäuse nicht stoppen.
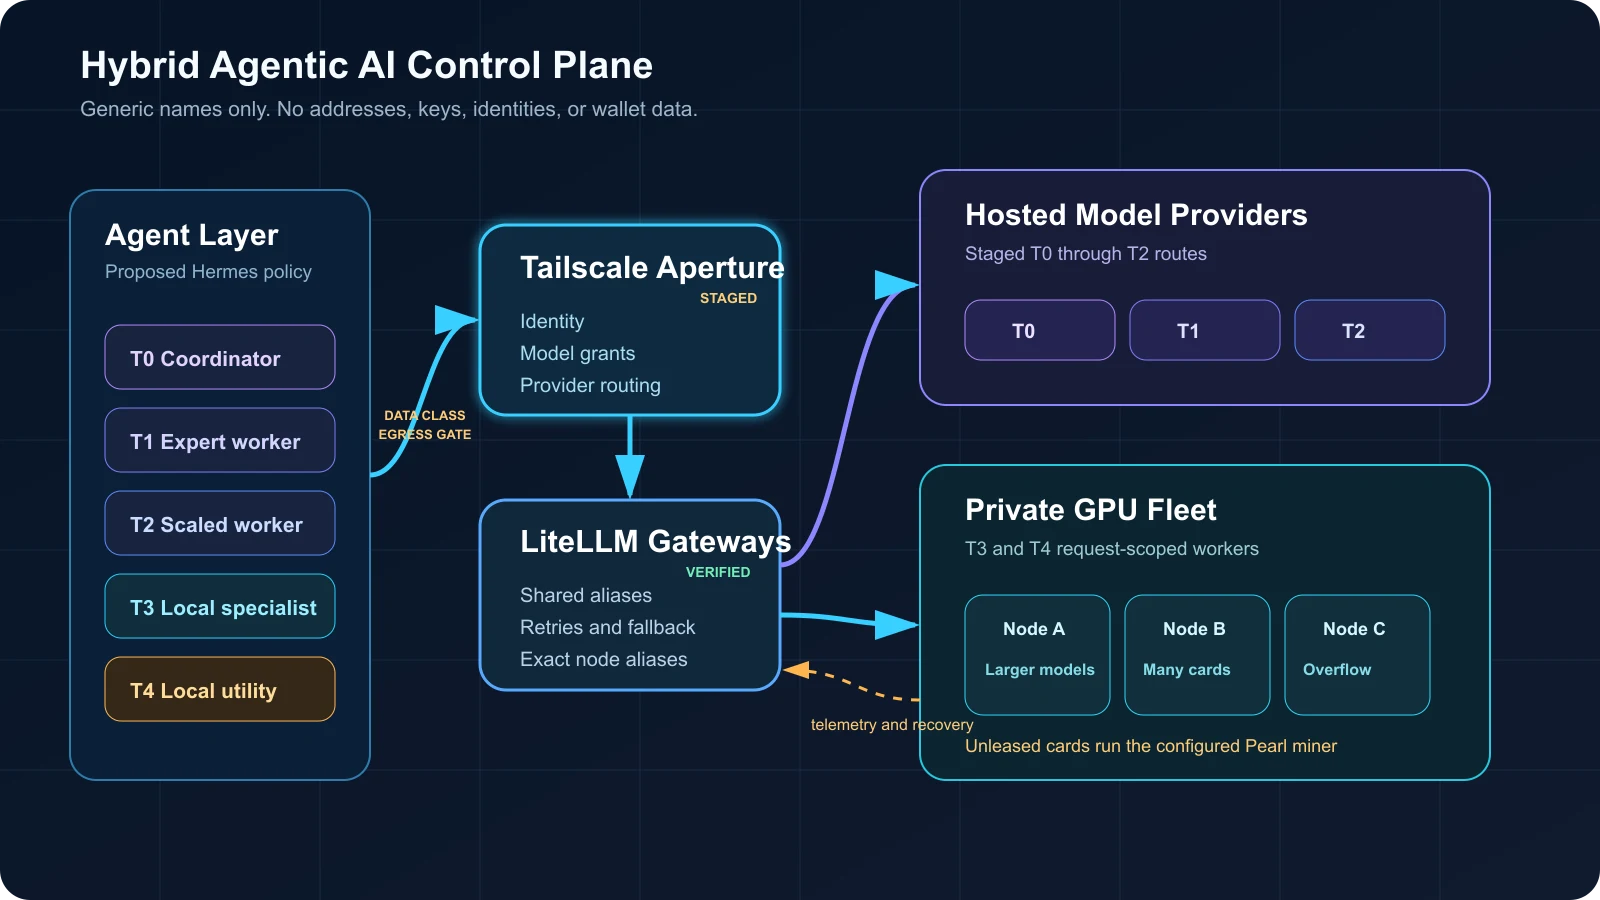
Der vorgeschlagene und vorbereitete Steuerpfad liegt über dem verifizierten LiteLLM- und GPU-Ausführungspfad
Das Diagramm verwendet allgemeine Knotennamen. Es enthält keine privaten Adressen, Nutzeridentitäten, Zugriffsschlüssel, Wallet-Daten oder Bezeichnungen physischer Hosts.
Was T0 bis T4 bedeuten
Die Stufennamen beschreiben unsere Routingrichtlinie. Sie sind kein Branchenstandard und bezeichnen nicht nur die Modellgröße.
| Stufe | Hauptaufgabe | Typisches Ziel | Verhalten bei Fehlern |
|---|---|---|---|
| T0 | Standardkoordinator und schwierigste Entscheidungen | Gehostetes Spitzenmodell für Schlussfolgerungen | Geordnete gehostete Ausweichkette |
| T1 | Wertvolle Arbeitsagenten | Gehosteter Pool leistungsfähiger Modelle | Innerhalb der zugewiesenen Kette erneut versuchen |
| T2 | Breiter Pool von Arbeitsagenten | Schnelle gehostete Modelle mit Eskalation | Schwierige Arbeit zu T1 oder T0 eskalieren |
| T3 | Umfangreiche private lokale Arbeit | Lokale Chat-, Code-, Prüf- und Visionmodelle mit 4B bis 12B | Geeigneten lokalen Knoten erneut versuchen, bei eingeschränkten Daten anschließend sicher abbrechen |
| T4 | Eng begrenzte, häufige lokale Aufgaben | Modelle mit 0,6B bis 3B für Routing, Klassifizierung, Code und Embeddings | Lokale Replik erneut versuchen oder innerhalb derselben Datengrenze zu T3 wechseln |
Die Stufe beschreibt zuerst die Aufgabe und dann das Modell. Eine kurze sicherheitssensible Klassifizierung passt in T4. Ein umfangreicher Repository-Plan gehört in T3 oder höher. Eine schwierige Architekturentscheidung beginnt auf einer höheren Stufe, auch wenn die Eingabe kurz ist.
Diese Aufteilung verändert auch die Wirtschaftlichkeit von Agenten. T4-Arbeiter erledigen wiederholte, risikoarme Umformungen. T3-Arbeiter halten übliche Code- und Analysearbeit im Tailnet. T0 bis T2 bleiben für schwierige Aufgaben und die Wiederherstellung nach Fehlern verfügbar.
Vor jedem gehosteten Ausweichpfad muss eine Dateneinstufung greifen. Öffentliche, interne und eingeschränkte Aufgaben erhalten getrennte Ketten. Eingeschränkte Arbeit bleibt lokal und wird bei Fehlern sicher abgebrochen. Für einen Wiederholungsversuch über eine Datengrenze hinweg braucht es bereinigte Eingaben und eine ausdrückliche Freigabe des Nutzers oder Workflows. Vor jedem gehosteten Aufruf entfernt die Bereinigung Zugangsdaten, Repository-Geheimnisse, private Werkzeugausgaben und sensible abgerufene Inhalte.
Wie Hermes die Aufgabenrichtlinie steuern soll
Hermes ist die vorgeschlagene Agentenebene. Die Zielrichtlinie weist eine Modellklasse zu, führt Werkzeuge aus, delegiert Arbeit und durchläuft ausdrücklich definierte Ausweichketten. Hermes dokumentiert getrennte Routen für das Hauptmodell, Zusatzaufgaben, delegierte Agenten und aufgabenspezifische Ausweichmodelle. Über eine Basis-URL unterstützt Hermes auch benutzerdefinierte, OpenAI-kompatible Endpunkte. Siehe die Hermes-Konfigurationsanleitung und den Leitfaden zu Ausweichanbietern .
Unsere Richtlinie ordnet Hermes-Aufgaben stabilen Aliasnamen statt physischen Servern zu. Beispiele:
t3-smart
t3-code
t3-review
t3-vision
t4-code
t4-classify
t4-router
t4-embedding
Der Alias beschreibt die Absicht. Hermes muss weder wissen, welche GPU frei ist, noch welcher Knoten eine größere Karte besitzt oder welche Replik ihre Zustandsprüfung nicht bestanden hat. Diese Entscheidungen treffen die unteren Ebenen.
Einige Aufgaben brauchen weiterhin eine feste Zuordnung. Eine Modell-ID mit Knotenpräfix sendet eine Diagnose oder einen Benchmark eines Operators an ein ausgewähltes System. Separate Aperture-Freigaben sollten diese Aliase auf Operatoren beschränken. Normaler Agentenverkehr nutzt gemeinsame Stufenaliase.
Der Modellzugriff sichert die Werkzeuge eines Agenten nicht ab. Der Hermes-Rollout braucht Werkzeug-Positivlisten mit minimalen Rechten, isolierte Arbeitsbereiche, beschränkte Zugangsdaten, Regeln für ausgehenden Netzwerkverkehr und Schutz vor Prompt-Injection. Delegierte Arbeiter sollten nicht mehr Zugriff erben, als ihre jeweilige Aufgabe erfordert.
Aperture als vorbereitete Identitätsgrenze
Tailscale verbindet das konfigurierte Gateway mit den Inferenzhosts, ohne jeden Dienst im öffentlichen Internet bereitzustellen. Aperture ist als nutzerseitige Grenze und Modellrouter vorbereitet. Diese Route benötigt noch einen End-to-End-Abnahmetest. Tailscale beschreibt den verschlüsselten Clientzugriff über das Tailnet und die TLS-Weiterleitung zum Anbieter in So funktioniert Aperture .
Aperture trennt außerdem Erreichbarkeit von Berechtigung. Freigaben verweigern Zugriffe standardmäßig. Ein Nutzer oder markiertes Gerät braucht nach dem Erreichen des Gateways eine passende Modellfreigabe. Der Aperture-Leitfaden zu Freigaben erklärt das additive Freigabemodell und die Identitätsquellen.
Die vorbereitete Aperture-Konfiguration sollte vor dem Einsatz vier Regeln erfüllen:
- Eine benannte Identität besitzt die Administratorrolle. Allgemeiner Modellzugriff verleiht keine Administrationsrechte.
- Anbieter führen konkrete Modell-IDs auf. Aperture leitet Modellnamen nicht aus einem vorgelagerten Dienst ab.
- Anbieter-URLs verweisen auf Tailnet-Adressen. Private Knotennamen und Adressen gehören weder in den Artikel noch in öffentliche Konfigurationsbeispiele.
- Geheimnisse bleiben in Dateien des jeweiligen Dienstes. Vor dem Einsatz gelten Nur-Eigentümer-Berechtigungen, beschränkte Dienstkonten, Schlüsselrotation und Log-Redaktion. Diagnoseausgaben dürfen niemals LiteLLM-Schlüssel, Tailnet-Adressen, Abonnementtokens oder Wallet-Daten ausgeben.
Aperture hängt den Pfad der eingehenden Anfrage an die Basis-URL jedes Anbieters an. Die
Konfigurationsreferenz
warnt davor, in der Anbieterbasis ein doppeltes /v1-Suffix anzugeben. Dieses Detail barg genug Integrationsrisiko, um eine ausdrückliche Prüfregel zu erhalten.
Vision ist für das OpenAI-Chat-Completions-Format mit Bildinhalten vorbereitet. Embeddings nutzen direkt den privaten LiteLLM-Endpunkt, weil Apertures aktuelle Matrix selbst gehosteter Anbieter Chat-Formate dokumentiert, während unser Embedding-Pfad von LiteLLM- und llama.cpp-Endpunkten außerhalb der Chat-Auswahl abhängt. Siehe die Referenz zu unterstützten Anbietern und Clients .
Der direkte Embedding-Pfad braucht eine eigene Autorisierungsgrenze. LiteLLM-Authentifizierung, restriktive Tailscale-Freigaben, Dienstbindung an die Tailnet-Schnittstelle und Host-Firewallregeln sollten den Zugriff auf genehmigte Identitäten oder Dienst-Tags begrenzen. Eine private Adresse allein ist keine Autorisierungsrichtlinie.
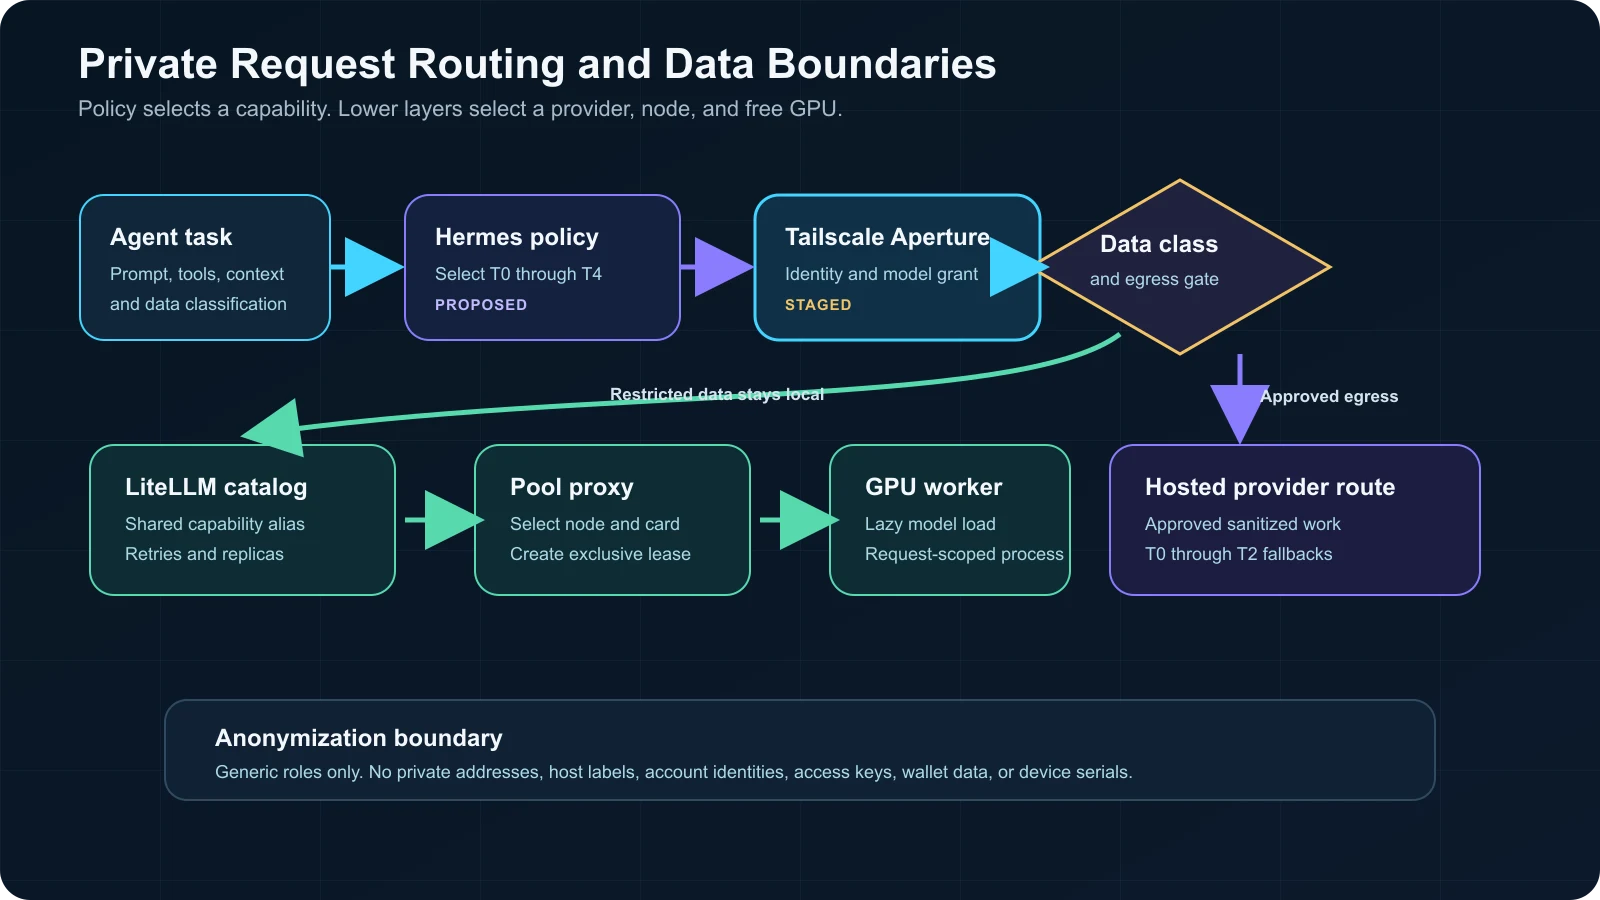
Identität, Freigaben und Dateneinstufung bestimmen, ob eine Anfrage die private Flotte verlässt
LiteLLM stellt einen Katalog bereit
Auf jedem Inferenzhost läuft ein LiteLLM-Gateway. Alle Gateways stellen denselben logischen Modellkatalog bereit, auch wenn sich ein Modell auf einem anderen Knoten befindet. Der Client behält ein API-Format und einen Satz von Aliasnamen.
LiteLLM gruppiert mehrere Bereitstellungen unter einem Modellnamen. Anschließend wählt der Router eine geeignete Bereitstellung aus und wendet Wiederholungen, Zeitüberschreitungen, Abkühlphasen oder Ausweichrouten an. Die aktuelle LiteLLM-Routingdokumentation behandelt gemeinsame Modellnamen, Routingstrategien und Wiederholungsverhalten.
Der Katalog nutzt zwei Adressarten:
| Adressart | Beispiel | Verwendung |
|---|---|---|
| Gemeinsamer Alias | t4-classify | Normale Arbeit auf geeignete Knoten verteilen |
| Knotenalias | node-b/qwen-small | Diagnosen ausführen oder die Platzierung festhalten |
Gemeinsame Aliase ermöglichen horizontale Skalierung, ohne Hermes zu ändern. Eine geeignete zusätzliche Replik erweitert die Modellgruppe. Eine fehlerhafte Replik zu entfernen verkleinert die Gruppe.
Die GPU-Lebenszykluslogik liegt unterhalb von LiteLLM. Das Gateway bleibt aktiv, weil sein Speicherbedarf keinen GPU-Speicher reserviert. Ein lokaler Pool-Proxy erhält die Anfrage für das ausgewählte Modell, leiht eine Karte aus, startet den Worker und beendet ihn nach der Antwort.
Lokaler Modellkatalog
Die Flotte bevorzugt Modelle mit höchstens 12B Parametern. Diese Grenze passt zum verfügbaren Kartenspeicher und lässt Platz für Kontext und Laufzeitpuffer.
Modellnotation: B steht für Milliarden Parameter. K steht für Tausende konfigurierte Kontexttokens. Quantisierung speichert Modellgewichte mit geringerer numerischer Genauigkeit, um den Speicherbedarf zu senken. Der KV-Cache hält den Aufmerksamkeitszustand des aktiven Kontexts und wächst mit der Eingabelänge. E4B ist Googles Größenbezeichnung für die kleinere Gemma-4-Variante.
| Stufenroute | Modellklasse | Konfigurierter Kontext | Hauptaufgabe | Platzierung |
|---|---|---|---|---|
| T3 intelligent | Qwen3.5 9B, quantisiert | 64K | Anspruchsvolle lokale Planung und allgemeine Agentenarbeit | GPU-Knoten mit mehr Speicher |
| T3 Code | Granite 4.2 8B, quantisiert | 64K | Repository-Arbeit, Werkzeuge, Terminalaufgaben, strukturierte Ausgabe | GPU-Knoten mit mehr Speicher |
| T3 Prüfung | Gemma 4 12B, quantisiert | 32K | Unabhängige Prüfung und alternatives Schlussfolgern | GPU-Knoten mit mehr Speicher |
| T3 allgemein und Vision | Qwen3.5 4B, quantisiert | 32K | Skalierbare allgemeine Arbeit und Bildverständnis | Alle kompatiblen GPUs |
| T3 alternative Prüfung | Gemma 4 E4B, quantisiert | 8K | Unterschiedlicher Prüfpfad | Alle kompatiblen GPUs |
| T4 Code | Granite 4.2 3B, quantisiert | 16K | Kleine Änderungen, Werkzeugaufrufe, strukturierte Ausgabe | Alle kompatiblen GPUs |
| T4 Klassifizierung | Qwen3.5 2B, quantisiert | 16K | Klassifizierung, Extraktion und Umschreibung | Alle kompatiblen GPUs |
| T4 Router | Qwen3.5 0.8B, hochpräzise quantisiert | 16K | Absicht, Labels, Titel und kurze Umformungen | Alle kompatiblen GPUs |
| T4 Embedding | Qwen3 Embedding 0.6B, quantisiert | 32K | Agentenspeicher, RAG, Codeabruf und Clusterbildung | Alle kompatiblen GPUs |
Diese Kontextwerte sind Bereitstellungseinstellungen, keine beworbenen Modellgrenzen. Ein größeres beworbenes Kontextfenster benötigt weiterhin KV-Cache und Laufzeitspeicher. Für stabilen Betrieb auf einer einzelnen Karte haben wir niedrigere Werte gewählt.
Qwen beschreibt Qwen3.5 als multimodale Familie und veröffentlicht kleine bis größere dichte Varianten in der Qwen3.5-Sammlung . IBM veröffentlicht Ergebnisse zu agentischer Programmierung und langem Kontext für Granite 4.2 8B . Google nennt multimodale Eingabe, Funktionsaufrufe und ein größeres beworbenes Kontextfenster für Gemma 4 .
Die Embedding-Route verwendet ein separates Modell, statt ein Chatmodell um Vektoren zu bitten. Die Modellkarte für Qwen3 Embedding 0.6B nennt eine Sequenzlänge von 32K, mehrsprachigen Abruf, Codeabruf und Ausgabedimensionen bis 1.024.
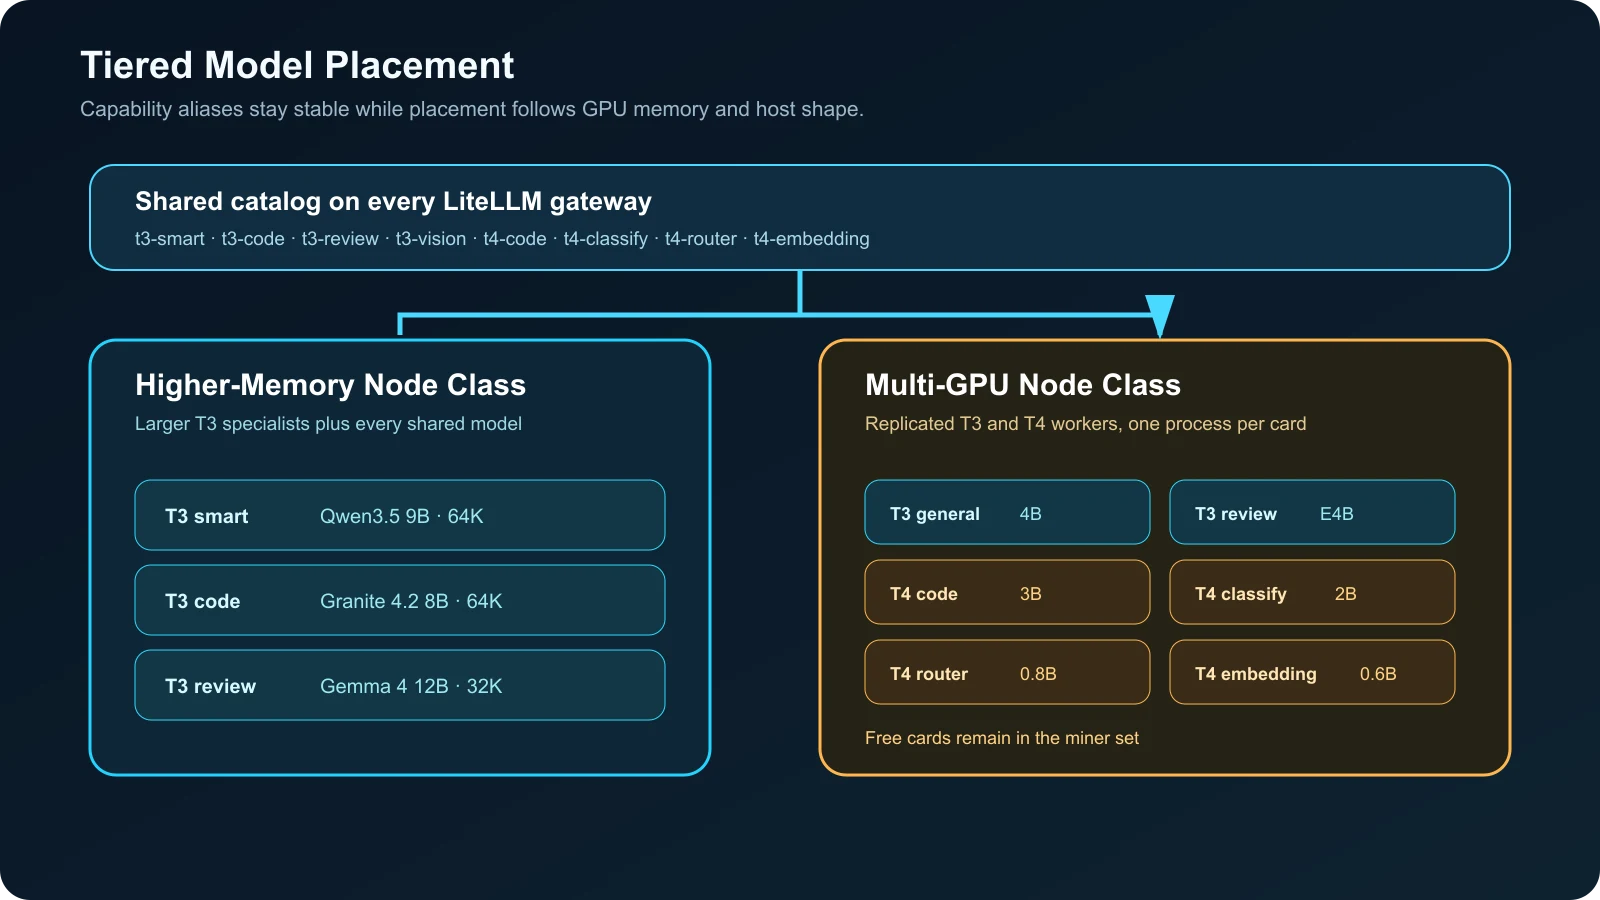
Größere Spezialmodelle bleiben auf speicherstärkeren Karten, kleinere Spezialmodelle werden in der Flotte repliziert
Warum llama.cpp in Produktion läuft
llama.cpp passt zum Ressourcenmodell. Ein statischer Worker entspricht einer GPU, einer Modelldatei, einem konfigurierten Kontext und einer Ausleihe. Durch die Prozessgrenze lassen sich Start, Ende, GPU-Sichtbarkeit und Protokolle leicht prüfen.
Der Server stellt OpenAI-kompatible Chat-, Responses- und Embedding-Schnittstellen bereit. Er unterstützt außerdem paralleles Dekodieren und kontinuierliche Stapelverarbeitung. Die aktuelle Serverdokumentation kennzeichnet multimodale Unterstützung als experimentell. Diese Funktionen sind in der llama.cpp-Serverdokumentation beschrieben.
Ollama bleibt auf einem größeren Knoten als Kompatibilitätspfad verfügbar. Wenn der Speicher reicht, unterstützt Ollama gleichzeitig geladene Modelle sowie sofortiges Entladen über keep_alive: 0, wie in der
Ollama-Hilfe
dokumentiert. Für den Produktionspfad pro Karte haben wir Ollama nicht gewählt, weil statische llama.cpp-Worker eine genauere Kontrolle über Platzierung und Beendigung boten.
Wir haben auch Strata geprüft. Strata zielt auf ein großes Qwen-Mixture-of-Experts-Modell, das GPU-Speicher, Systemspeicher und Speicherlaufwerke nutzt. Die veröffentlichten Voreinstellungen beginnen bei 32 GB kombiniertem Speicher. Der Modus für wenig RAM tauscht Geschwindigkeit gegen geringere Kapazität. Siehe das Strata-Codearchiv . Strata passt zu einem anderen Ziel: einem größeren hybriden Modell über eine oder mehrere Karten. Unsere Flotte bevorzugt viele unabhängige Worker unter 12B.
Bedarfsgerechtes Laden pro GPU
Bedarfsgerechtes Laden gilt für jeden Modellworker. Zwischen Anfragen bleiben nur Gateways, Pool-Proxys, Wächter und Miner aktiv.
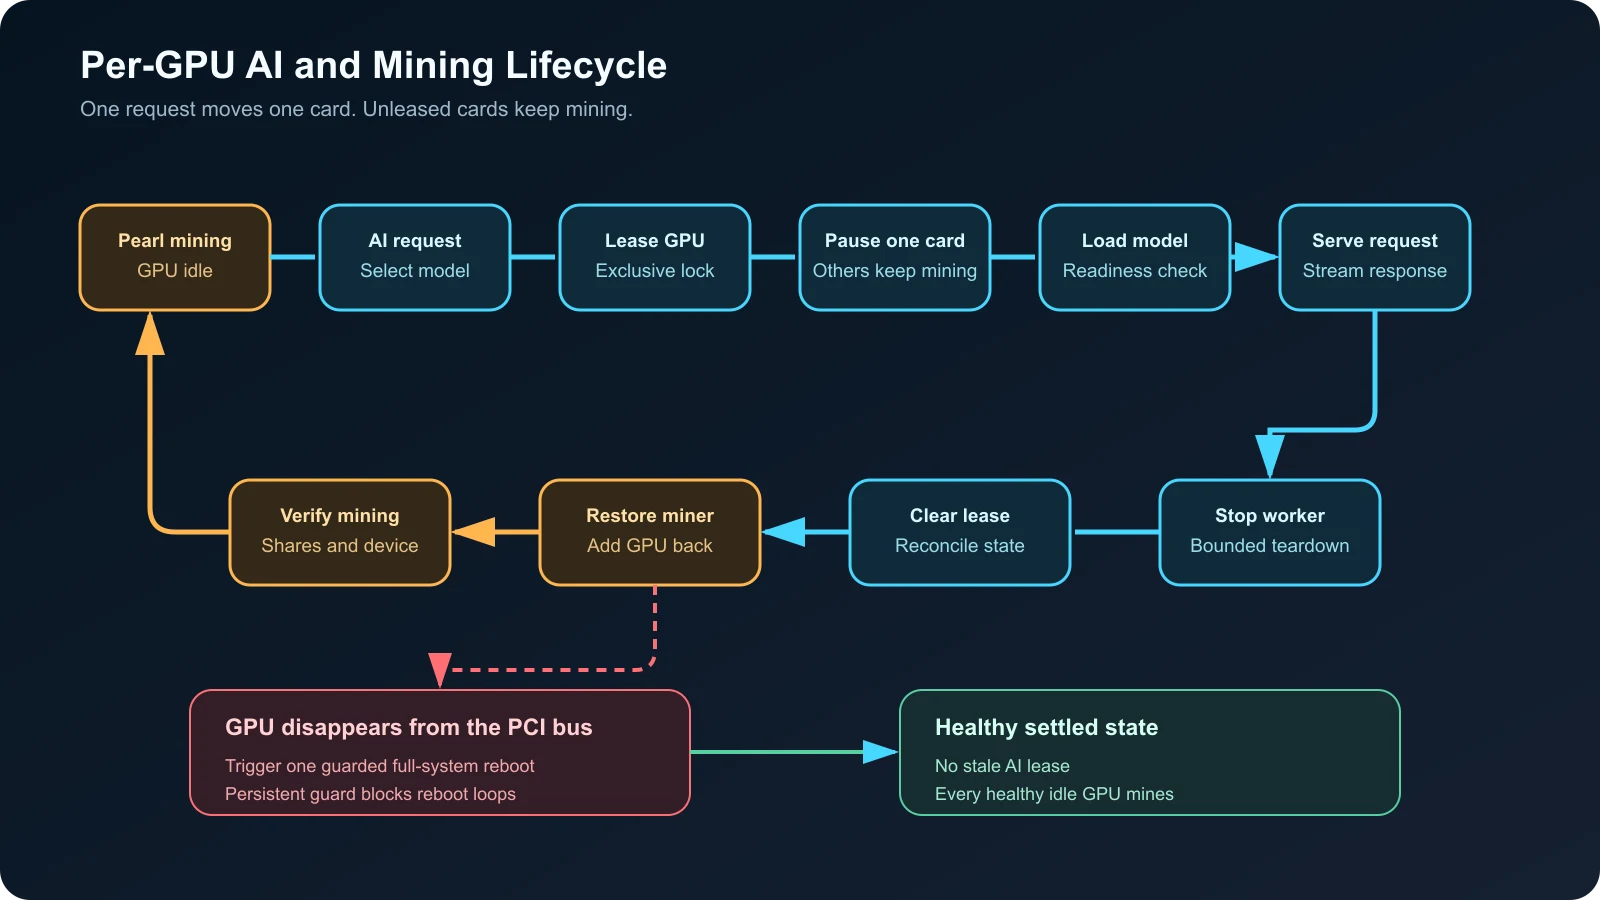
Nur die ausgeliehene Karte verlässt den Miner und kehrt nach Ende des Modellprozesses zurück
Der Anfragezyklus besteht aus diesen Schritten:
- LiteLLM wählt eine Bereitstellung. Die Anfrage erreicht einen Pool-Proxy für die gewählte Modellklasse.
- Der Pool nimmt eine Ausleihe vor. Eine Sperre verhindert, dass zwei exklusive Worker dieselbe Karte belegen.
- Der Miner startet ohne eine GPU neu. Alle nicht ausgeliehenen Karten bleiben im Pearl-Befehl enthalten.
- llama.cpp startet auf dem ausgeliehenen Gerät. Bereitschaftsprüfungen sind abgeschlossen, bevor der Proxy die Anfrage weiterleitet.
- Der Worker liefert die Antwort. Gleichzeitige Anfragen starten Worker auf anderen freien Karten.
- Der Worker wird beendet. Der Pool entfernt die Ausleihe nach dem Prozessende.
- Der Miner startet mit der freigegebenen GPU neu. Zustandsprüfungen bestätigen, dass die Karte wieder am Mining teilnimmt.
Das unterscheidet sich von einem vollständigen Umschalten des Hosts. Ein Gehäuse mit mehreren Karten bedient mehrere Modelle, während die übrigen Karten weiter minen. Im Leerlauf gibt die Flotte jede gesunde GPU an Pearl zurück.
Das Pearl-Hintergrundpapier beschreibt sein Proof-System für Matrixberechnungen. Unsere Architektur hängt weder von einer Rentabilitätsprognose noch von einer Behauptung über wirtschaftlichen Ertrag ab. Mining ist die konfigurierte Leerlaufaufgabe.
Fehlerbehandlung ist wichtiger als der Start
Der Modellstart ist nur die Hälfte des Lebenszyklus. Erzwungene Stopps, verschwundene GPUs, unterbrochene Anfragen, veraltete Ausleihen und Miner-Neustarts brauchen eine ausdrückliche Behandlung.
Unser Wächter vergleicht die konfigurierte GPU-Menge mit der aktiven NVIDIA-Geräteliste. Eine bestätigte fehlende GPU löst einen einzelnen, abgesicherten Neustart des gesamten Systems aus. Ein sicherer Produktionsauslöser sollte mehrere fehlgeschlagene Prüfungen, eine Abkühlzeit, das Leeren aktiver Aufgaben, einen persistenten Neustartzähler und eine externe Warnung verlangen. Eine fehlgeschlagene Wiederherstellung sollte die Automatisierung stoppen und manuelles Eingreifen erfordern.
Derselbe Wächter gleicht veraltete Ausleihen ab. Wenn kein Worker eine Ausleihe besitzt, entfernt der Abgleich den veralteten Eintrag und gibt die GPU an den Miner zurück. Dieser Wiederherstellungspfad war während des Broker-Canarys wichtig.
| Fehler | Reaktion |
|---|---|
| Modell wird nicht bereit | Worker stoppen, Ausleihe freigeben, Mining wiederherstellen, Fehler zurückgeben |
| Anfrage endet unerwartet | Aufräumzeit begrenzen, gesamten Worker-Prozessbaum beenden, Ausleihe abgleichen |
| GPU verschwindet | Wiederholte Ausfälle bestätigen, aktive Arbeit leeren, einen abgesicherten Neustart auslösen, alarmieren und anschließend die vollständige konfigurierte GPU-Menge prüfen |
| Miner lässt eine ungenutzte Karte aus | Geräteliste aus aktiven Ausleihen neu aufbauen und Miner neu starten |
| LiteLLM-Bereitstellung fällt aus | Eine andere Replik derselben Modellgruppe versuchen und dann die Ausweichrichtlinie anwenden |
| Aperture-Freigabe blockiert eine Route | Identität oder Modellfreigabe korrigieren, Gatewayrichtlinie niemals umgehen |
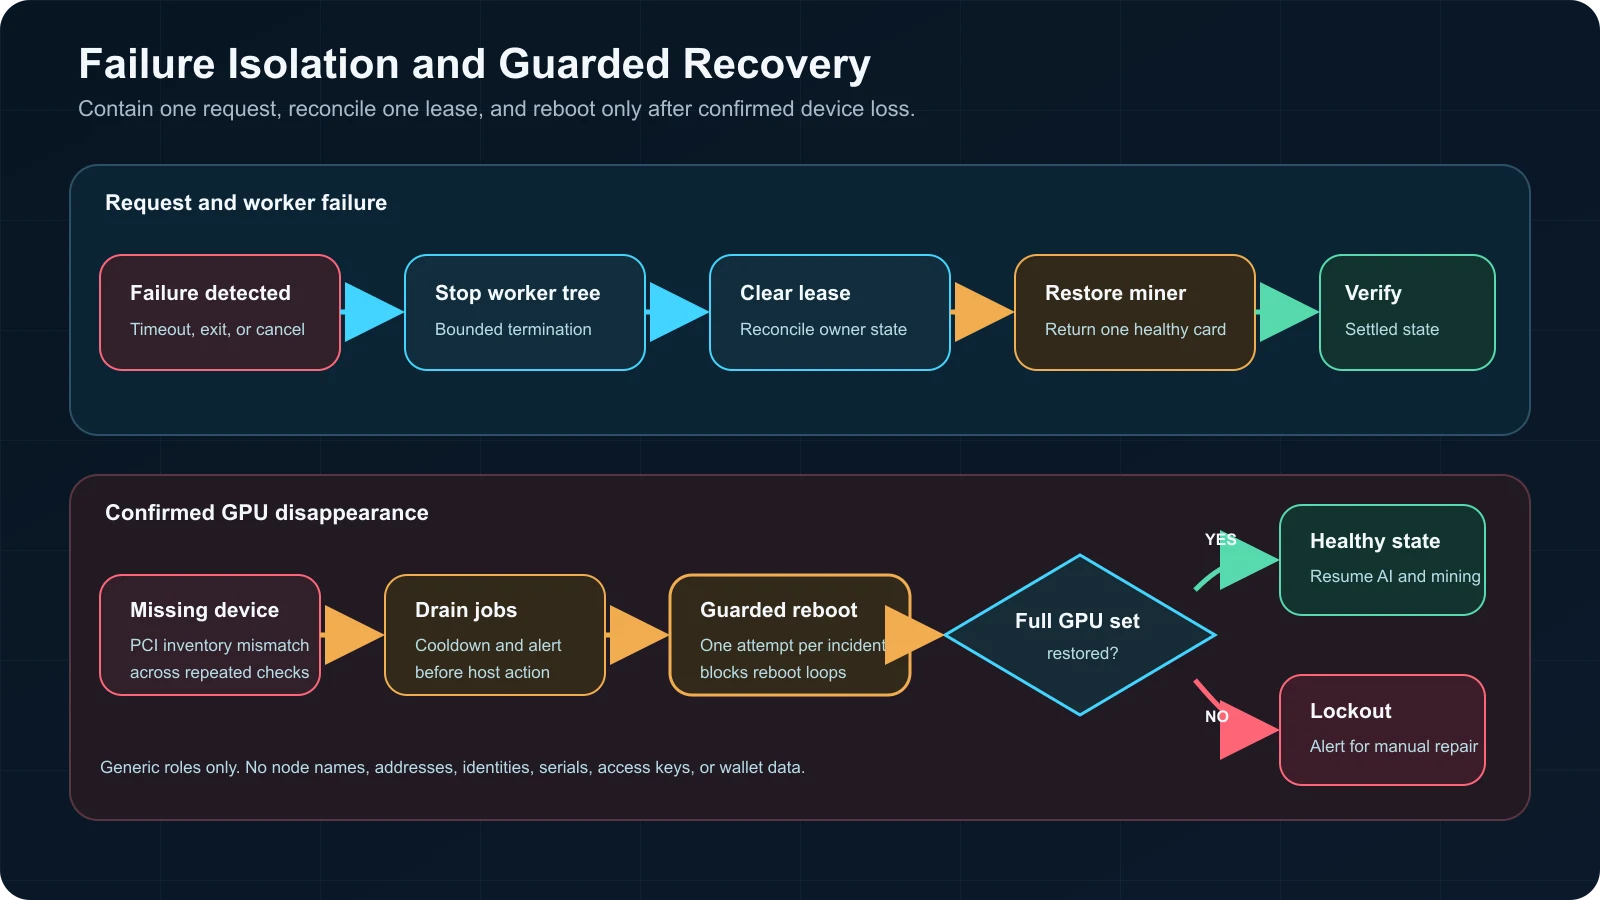
Alltägliche Fehler geben eine einzelne Ausleihe frei; bestätigter Geräteverlust aktiviert den abgesicherten Wiederherstellungspfad des Hosts
Was mit dem experimentellen Broker geschah
Der backendunabhängige Broker soll eine OpenAI-kompatible Oberfläche für Ollama, vLLM, llama.cpp und Strata bereitstellen. Er enthält Lebenszyklusverwaltung pro Modell, Entladen im Leerlauf und GPU-Platzierung.
Wir testeten Broker-Version 0.6.0 mit Commit c12b65 am 21. Oktober 2026. Die lokale Testsuite meldete 1.101 bestandene und 2 übersprungene Tests; Ruff war fehlerfrei. Der Canary lud anschließend ein Modell bei Bedarf und bediente eine erfolgreiche Chat-Anfrage. Andere GPUs mineten während der Anfrage weiter.
Beim Herunterfahren zeigte sich ein kritisches Lebenszyklusproblem. Nachdem ein Modell geladen war, blieb der Broker im Stoppvorgang hängen, bis systemd den Prozessbaum beendete. Der erzwungene Stopp hinterließ eine veraltete GPU-Ausleihe, bis der Abgleich den Miner wiederherstellte. Außerdem fanden wir eine Lücke zwischen der dokumentierten GPU-Pflichteinstellung und ihrer Durchsetzung im Produktionsadapter.
Wir deaktivierten den Broker im Produktionspfad. LiteLLM routet jetzt über den anfragebezogenen Pool-Proxy. Der Broker bleibt experimentell, bis Integrationstests das zeitlich begrenzte Beenden von Kindprozessen, die Terminierung von Prozessgruppen, die Admission-Prüfung erforderlicher GPUs und die Bereinigung veralteter Ausleihen bestehen.
Das Ergebnis liefert eine nützliche technische Lehre. Ein Broker beweist wenig, wenn er ein Modell einmal starten kann. Produktionsreife hängt von sauberem Beenden, begrenzter Wiederherstellung, exklusiver Gerätefreigabe und wiederholbaren Fehlerübungen ab.
Durchgeführte Prüfungen
Der Bereitstellungstest umfasste mehr als eine Modellantwort:
- Jedes gemeinsame Chatmodell durchlief Laden, Antwort, Beenden und Pearl-Wiederherstellung auf mindestens einem geeigneten Host.
- Vision nahm Bildeingaben über die Chatroute an.
- Embeddings lieferten die konfigurierte Vektorgröße über den privaten LiteLLM-Pfad.
- Mehrere Modelle liefen gleichzeitig auf getrennten Karten.
- Nicht ausgeliehene Karten blieben während gleichzeitiger KI-Anfragen beim Miner.
- Gemeinsame Aliase routeten über geeignete Knoten.
- Aliase mit Knotenpräfix behielten eine deterministische Platzierung.
- Jedes LiteLLM-Gateway listete denselben logischen Katalog auf.
- Eine fehlende GPU erholte sich nach einem vollständigen Hostneustart. Der Wächter hat jetzt eine persistente Schleifensperre.
- Ein Fehler beim Herunterfahren des Brokers wurde durch Ausleihabgleich behoben.
- Im stabilen Endzustand gab es keine KI-Ausleihen und jede gesunde GPU gehörte wieder zur Minermenge.
Zustandsprüfungen und Modelllisten galten nicht als Modell-Ladetests. Ein brauchbarer Abnahmetest sendet eine echte Anfrage, prüft die Antwort, bestätigt die ausgewählte GPU, beobachtet das Beenden und kontrolliert die Wiederaufnahme des Minings.
Flotte gezielt untersuchen
| Symptom | Erste Prüfung |
|---|---|
| Modell wird angezeigt, aber Anfragen schlagen fehl | Vorgelagerte Modell-ID, API-Format, Authentifizierungsheader und Basis-URL des Anbieters |
| Aperture liefert 405 | Anbieterbasis enthält kein doppeltes /v1-Suffix |
| Anfrage landet auf dem falschen Knoten | Gemeinsamer Alias oder Alias mit Knotenpräfix |
| Zwei Worker zielen auf dieselbe Karte | Ausleihsperre, veralteter Ausleihestatus und GPU-Zulassungslogik |
| Mining stoppt auf allen Karten | Neustartcode des Miners erstellt die Geräteliste anhand aktiver Ausleihen |
| GPU nimmt das Mining nicht wieder auf | Worker-Prozessbaum, Ausleihabgleich und Geräteliste des Miners |
| Kaltstart ist langsam | Modellgröße, Speichergeschwindigkeit, PCIe-Linkbreite und CPU-Last des Hosts |
| Lange Eingaben schlagen fehl | Konfigurierter Kontext, KV-Cache-Spielraum und reservierte Ausgabegröße |
| Embedding-Route fehlt in Aperture | Authentifizierte LiteLLM-Route mit Beschränkungen durch Tailscale-Identität und Host-Firewall verwenden |
| Broker-Stopp hängt | Brokerroute deaktivieren und Verkehr zum verifizierten Pool-Proxy zurückführen |
Bewährte Designregeln
- Nach dem Zweck der Aufgabe routen. Die Modellgröße allein legt keine Stufe fest.
- Richtlinie oberhalb der Platzierung halten. Hermes wählt einen Fähigkeitsalias. LiteLLM wählt eine Bereitstellung. Der Pool wählt eine GPU.
- Jede GPU als eigene Ausleihe behandeln. Ein hostweites Umschalten verschwendet verfügbare Karten.
- Jedes inaktive Modell entladen. Aktive Gateways brauchen keine aktiven GPU-Worker.
- Einen eingeschränkten Pfad mit genauer Platzierung behalten. Nur Operatoren vorbehaltene Knotenaliase machen Diagnosen reproduzierbar.
- Zuerst das Beenden testen. Miner-Wiederherstellung und Ausleihbereinigung gehören in die Abnahmetests.
- Chat, Vision und Embeddings trennen. Ein Gateway bedeutet nicht einen einzigen Protokollpfad.
- Private Details aus Diagrammen heraushalten. Rollen und Abläufe veröffentlichen, keine Adressen, Schlüssel, Identitäten oder Wallet-Daten.
- Neustartlogik absichern. Mehrfaches Fehlen, Abkühlzeit, persistenten Zähler, Alarm und manuelles Eingreifen nach einem fehlgeschlagenen Wiederherstellungsversuch verlangen.
- Einen experimentellen Ausweg behalten. Ein fehlerhafter Broker darf den verifizierten Pfad nicht mitreißen.
Nächste Schritte
Als Nächstes bewerten wir Arbeitslasten. Jede Stufe braucht einen festen Aufgabensatz, Abnahmekriterien, Latenzaufzeichnungen, GPU-Auslastung, Unterbrechungsdauer des Minings und Eskalationsraten. Diese Messungen zeigen, welche T2-Aufgaben zu T3 gehören und welche T3-Aufgaben in T4 passen.
Außerdem wollen wir den ersten Hermes-über-Aperture-über-LiteLLM-Abnahmetest durchführen und den Broker erneut testen, nachdem seine Abschalt- und GPU-Zulassungspfade korrigiert wurden. Die Bildgenerierung braucht einen eigenen OpenAI-kompatiblen Adapter mit bedarfsgerechtem Laden, bevor sie in denselben Routingkatalog aufgenommen wird.
Zur Modellbemessung lies den Leitfaden zu lokalen KI-Modellen und GPU-Kontext . Zu Datenschutzgrenzen lies Datenschutz und Sicherheit lokaler KI . Für Minereinrichtung und Risiken lies den Pearl-Mining-Leitfaden , statt inaktives Mining als garantierten Gewinn zu betrachten.
Related Posts