2x RTX 5060 Ti gegen GB10: Warum 32 GB VRAM gegen 128 GB gemeinsamen Speicher verlieren
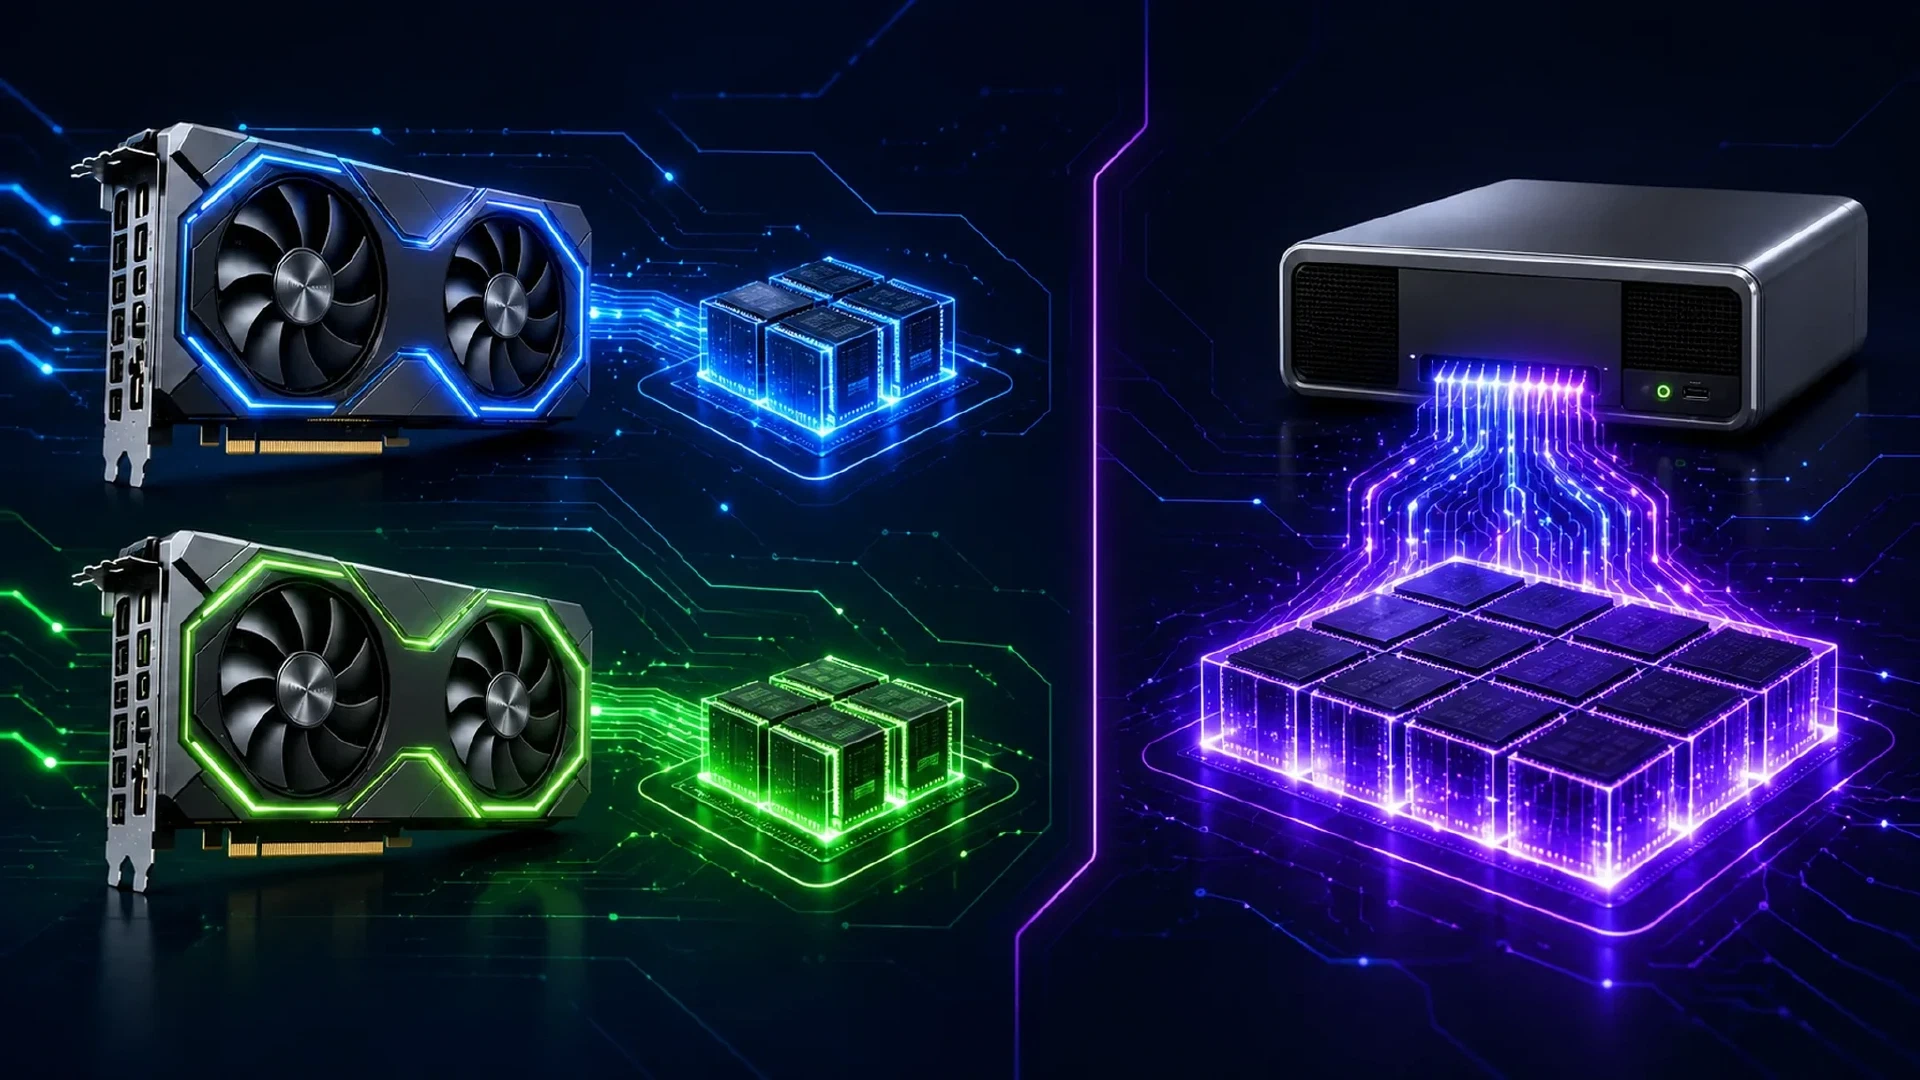
Table of Contents
Zwei RTX 5060 Ti Karten mit 16 GB wirken auf einer Teileliste attraktiv. Sie bieten insgesamt 32 GB VRAM und starke Prompt-Verarbeitung bei kurzem Kontext. Die Bewertung ändert sich, wenn du ein 27B-Modell mit langem Kontext ausführst.
Das NVIDIA GB10 System nutzt 128 GB kohärenten gemeinsamen Speicher. NVIDIA führt die GB10-Plattform mit 128 GB gemeinsamem LPDDR5x-Speicher und einer Chip-TDP von 140 W. Die RTX 5060 Ti nutzt 16 GB GDDR7 pro Karte, eine 128-Bit-Schnittstelle und eine Gesamtleistung von 180 W. Die Spezifikationen der NVIDIA RTX 5060 Ti und die Spezifikationen des NVIDIA GB10 zeigen den Hardwareunterschied.
Der Punkt ist einfach. Zwei Karten mit 16 GB bilden keinen schnellen Speicherpool mit 32 GB. Sie bilden zwei getrennte Pools mit je 16 GB, die über das Hostsystem verbunden sind. Bei der Inferenz großer Modelle zählen die fehlende Kapazität und die Datenbewegung zwischen Geräten stärker als die Kartenzahl.
Der Speichervergleich
| System | Speicher | Speichermodell | Angegebener Leistungswert |
|---|---|---|---|
| 2x RTX 5060 Ti 16 GB | 32 GB gesamt | Zwei getrennte GPU-Speicherpools | 360 W GPU gesamt |
| GB10-System | 128 GB | Kohärenter gemeinsamer Systemspeicher | 140 W GB10-TDP |
GB10 gewinnt nicht, weil 128 GB LPDDR5x dieselbe Bandbreite wie eine diskrete High-End-GPU bieten. Der Vorteil entsteht durch Kapazität und Platzierung. CPU und GPU teilen denselben Adressraum. Modell, Laufzeitpuffer, Aktivierungen und Kontextdaten müssen daher nicht in zwei isolierte Geräte mit je 16 GB passen.
Das Zwei-Karten-System hat ein schwierigeres Platzierungsproblem. Das Modell muss auf beide Karten verteilt werden. Die Inferenz-Laufzeit muss Daten zwischen ihnen bewegen. PCIe-Verkehr erhöht die Latenz und verbraucht Bandbreite. Laut NVIDIA unterstützt die RTX 5060 Ti außerdem kein NVLink.
Das Benchmark-Ergebnis
Die folgenden Ergebnisse stammen aus dem bereitgestellten KI-Benchmarkbericht. Der Bericht vergleicht ein unbenanntes Dual-GPU-System namens 5060ti-x2 mit einem GB10-System. Der Test umfasst Qwen und GPT-OSS bei mehreren Kontextgrößen.
Die Modelle kamen direkt aus Ollama. Der Test verwendete die wörtlichen Standard-Tags qwen3.8:27b und gpt-oss:latest, ohne eigenes Modelfile und ohne alternative Quantisierung. Das 5060ti-x2-System nutzte PCIe Gen4 x16 und die neuesten verfügbaren NVIDIA-Linux-Treiber beim Benchmark.
Qwen-Promptverarbeitung und Generierung
| Kontext | 5060ti-x2 Prompt tok/s | 5060ti-x2 Generierung tok/s | GB10 Prompt tok/s | GB10 Generierung tok/s |
|---|---|---|---|---|
| 4K | 862.5 | 56.9 | 57.4 | 27.7 |
| 16K | 917.3 | 53.5 | 62.1 | 28.1 |
| 32K | 881.4 | 48.8 | 62.4 | 26.9 |
| 64K | 795.1 | 39.6 | 59.9 | 26.1 |
| 128K | 538.7 | 28.3 | 59.9 | 28.6 |
| 256K | 189.9 | 1.2 | 59.9 | 25.8 |
Bei 4K generiert das Dual-Karten-System etwa doppelt so schnell wie GB10. Bei 64K sinkt der Vorsprung auf etwa das 1,5-Fache. Bei 128K erreichen beide Systeme ungefähr dieselbe Generierungsgeschwindigkeit.
Bei 256K sieht das Zwei-Karten-System nicht mehr wie der Gewinner aus. Die 5060ti-x2-Anfrage erreichte nur 171.359 tatsächliche Prompt-Tokens. Die Generierung fiel auf 1,2 Tokens pro Sekunde. GB10 schloss den vollständigen 256K-Test mit 25,8 Tokens pro Sekunde ab.
GB10 generierte im getesteten 256K-Ergebnis etwa 21,5-mal schneller. Wichtiger ist, dass GB10 den angeforderten Kontext abschloss. Das Dual-GPU-System lieferte nicht dieselbe Arbeitslast.
Warum aggregierter VRAM irreführt
1. Das Modell sieht keine einzelne Karte mit 32 GB
Zwei GPUs verschmelzen ihren Speicher nicht zu einem lokalen Adressraum. Eine Modellparallel-Laufzeit teilt Schichten oder Tensoren auf die Geräte auf. Jedes Gerät braucht weiterhin Platz für seine Gewichte, temporären Puffer und einen Teil des Kontextzustands.
Die nutzbare Kapazität liegt daher unter der einfachen Summe. Der genaue Overhead hängt von Modellformat, Quantisierung, Inferenz-Backend, Tensoraufteilung und Kontextlänge ab.
2. Der Kontextspeicher wächst während der Generierung
Die Modellgewichte bilden nur einen Teil des Speicherbudgets. Der Key-Value-Cache, kurz KV-Cache, speichert Aufmerksamkeitsdaten früherer Tokens. Längere Kontexte brauchen mehr Cache-Speicher. Ein 4K-Test sagt nichts Sicheres über eine Bereitstellung mit 128K oder 256K aus.
Die Ergebnisse zeigen diese Grenze deutlich. Das Dual-Karten-System behält einen starken Vorsprung bei der Prompt-Verarbeitung und verliert dann mit wachsendem Kontext Generierungsleistung. GB10 bleibt von 4K bis 256K bei etwa 26 bis 29 Generierungs-Tokens pro Sekunde.
3. PCIe-Transfers verursachen Kosten
Wenn die Laufzeit Aktivierungen oder Tensoren zwischen GPUs verschiebt, läuft der Transfer über die Host-Verbindung. Das erzeugt Synchronisationspunkte und zusätzliche Latenz in jedem Schritt. Die Belastung steigt, wenn die Arbeitslast die Gerätegrenze wiederholt überschreitet.
Das macht ein Dual-GPU-System nicht unbrauchbar. Die Speicherplatzierung ist ein Teil des Leistungsergebnisses. Ein Benchmark, der nur die Prompt-Verarbeitung bei 4K meldet, verpasst diese Kosten.
4. Energieeffizienz ist ein Vorteil des Gesamtsystems
GB10 verbraucht im Vergleich weniger Energie und bietet für die getestete Langkontext-Arbeitslast mehr Speicherkapazität. Zwei RTX 5060 Ti tragen zusammen 360 W GPU-Leistung, bevor der Rest des Systems zählt. NVIDIA gibt die GB10-TDP mit 140 W an.
GB10 tauscht maximale Kurzkontext-Geschwindigkeit gegen Kapazität, Abschluss und niedrigere GPU-Leistung. Für lange Qwen-Kontexte zählen diese Abwägungen.
Das 5060ti-x2-System kostet deutlich weniger
Der Leistungsvergleich beseitigt den Preisunterschied nicht. Eine vollständige Workstation mit zwei RTX 5060 Ti 16 GB war am 10. Oktober 2026 für 3.479 US-Dollar gelistet. Die Konfiguration umfasst Intel Ultra 7 265K, Z890-Mainboard, 32 GB DDR5, 1 TB Speicher, ein 1.000-W-Netzteil und beide GPUs. Vollständige Workstation mit zwei GPUs ansehen .
Der US-Marktplatz von NVIDIA listet den 128-GB-DGX-Spark für 6.950 US-Dollar. Die Liste umfasst 128 GB kohärenten gemeinsamen Speicher und 4 TB NVMe-Speicher, zeigt das System aber als nicht vorrätig. Aktuelle DGX-Spark-Liste von NVIDIA prüfen .
Die AMD Ryzen AI Halo Developer Platform liefert einen weiteren Vergleich. Dieses Strix-Halo-System kostet bei Micro Center 3.999,99 US-Dollar und bietet 128 GB gemeinsamen LPDDR5x-Speicher sowie 2 TB Speicher. Strix Halo liegt oft in derselben praktischen Klasse für lokale KI wie GB10-Systeme, obwohl unabhängige Tests GB10 bei Durchsatz und Software-Reife häufig vorne messen. Aktuelle Micro-Center-Linux-Liste prüfen und den Vergleich von Strix Halo und GB10 lesen .
| Komplettsystem | Gelisteter Preis am 10. Oktober 2026 | Preisunterschied |
|---|---|---|
| 5060ti-x2-Workstation | $3,479 | Ausgangswert |
| AMD Ryzen AI Halo, Strix Halo | $3,999.99 | $520.99 mehr |
| 128-GB-GB10-DGX-Spark | $6,950 | $3,471 mehr |
GB10 bietet einen größeren gemeinsamen Speicherpool, geringeren Energieverbrauch und eine bessere Architektur für lange Kontexte. Das AMD-System bietet dieselbe Speicherkategorie mit 128 GB für ungefähr 4.000 US-Dollar. Die 5060ti-x2-Workstation bleibt bei etwa 50 % des gelisteten GB10-Preises, vor Steuer und Versand. Käufer, die gemeinsamen Speicher brauchen, aber nicht NVIDIAs Software-Stack, erhalten mit Strix Halo eine günstigere Alternative.
Dies sind gelistete Preise verschiedener Anbieter, keine kontrollierte Einzelhandelspreisliste. Der Vergleich lässt das 5060ti-x2-System außerdem mit weniger Systemspeicher und Speicherplatz zurück. Der Preisunterschied zählt trotzdem, weil beide Angebote vollständige, nutzbare Computer und keine reinen GPU-Preise beschreiben. Aktuelle RTX-5060-Ti-16-GB-Karten liegen bei 789 bis 830 US-Dollar pro Karte, deutlich über der Einführungsempfehlung von 429 US-Dollar. Der Preisvorteil des Zwei-Karten-Systems bleibt daher auch beim aktuellen GPU-Preisanstieg bestehen. Aktuelle RTX-5060-Ti-Preisprüfungen .
Das GPT-OSS-Ergebnis braucht eine getrennte Betrachtung
Der gleiche Bericht zeigt für 5060ti-x2 starke GPT-OSS-Generierungsergebnisse von 4K bis 256K. GB10 schließt die Tests von 4K bis 128K ab, der GPT-OSS-Test bei 256K ist aber als nicht unterstützt markiert.
Verwende die GPT-OSS-Tabelle nicht für die Behauptung eines allgemeinen Siegers. Die Tests decken bei 256K nicht denselben Bereich ab. Das Qwen-Ergebnis liefert den saubereren Langkontextvergleich, weil beide Systeme ein Ergebnis bei 256K melden, obwohl der 5060ti-x2-Lauf nur 171.359 tatsächliche Prompt-Tokens erreichte.
Was dies für einen Qwen-3-27B-Build bedeutet
Ein Zwei-Karten-System mit 16 GB könnte ein quantisiertes 27B-Modell mit kleinerem Kontext ausführen. Der Benchmark widerlegt diesen Anwendungsfall nicht. Die Daten widerlegen die Behauptung, dass 32 GB aggregierter VRAM denselben praktischen Spielraum wie ein System mit 128 GB gemeinsamem Speicher bieten.
Dass ein Modell auf eine Karte passt, beweist nur die Gewichtskapazität. Der tatsächliche Speicherbedarf besteht aus Modellgewichten, aktivem Kontext, KV-Cache, Laufzeitpuffern und Betriebssystemreserve. Der Kontext muss neben dem Modell Platz finden. Ein geladenes Modell ohne Raum für das Arbeitsgespräch ist kein brauchbares Langkontext-System.
Dies entspricht den Größenempfehlungen in Reichen 16 GB VRAM für ernsthafte lokale LLM-Arbeit? . Dort werden Gewichte, Kontext und Laufzeitzuweisungen als ein Budget behandelt. Der 32-GB-VRAM-Leitfaden für Qwen 27B kommt für Zwei-Karten-Systeme zum gleichen Schluss. Aggregierte Kapazität entspricht nicht nutzbarem Spielraum.
Stelle vor dem Kauf für eine Qwen-3-27B-Bereitstellung vier Fragen:
- Passt die gewünschte Quantisierung mit Laufzeitpuffern? Modellgewichte allein bestimmen den Speicherbedarf nicht.
- Passt der Kontext ohne starken KV-Cache-Druck? Lange Prompts ändern das Ergebnis.
- Verwendet die Laufzeit eine schnelle Geräteaufteilung? PCIe-Transfers und Tensorplatzierung beeinflussen jedes erzeugte Token.
- Schließt das System den Zielkontext ab? Ein schnelles 4K-Ergebnis gleicht eine fehlgeschlagene 256K-Arbeitslast nicht aus.
Der bereitgestellte Test beantwortet die letzte Frage für das Dual-Karten-System. Der Lauf erreichte während der 256K-Qwen-Anfrage 171.359 Tokens und generierte 1,2 Tokens pro Sekunde. GB10 schloss 256K mit 25,8 Tokens pro Sekunde ab.
Für diese Langkontext-Arbeitslast ist gemeinsamer Speicher die bessere Architektur, wenn die Alternative PCIe braucht, um den Arbeitssatz des Modells zu überspannen. PCIe bleibt ein Kapazitäts-Workaround. PCIe schafft weder denselben Speicherpool noch dieselbe Latenz oder denselben Transferpfad. Der GPU-Kontextleitfaden für lokale KI erklärt, warum Modellgewichte, KV-Cache, Toolausgabe und Laufzeitpuffer gemeinsam dimensioniert werden müssen. Der Ollama-Qwen3.8-27B-GPU-Benchmark zeigt außerdem, warum Langkontextergebnisse getrennt von Kurzkontext-Decodezahlen betrachtet werden müssen.
Fazit
Zwei RTX 5060 Ti 16 GB sind ein schlechter Ersatz für GB10, wenn das Ziel Langkontext-Inferenz mit 27B ist. Sie liefern bei kurzen Kontextgrößen höheren Prompt-Durchsatz. Sie verbrauchen auch mehr GPU-Leistung und setzen die Laufzeit einem geteilten Speicherlayout aus.
GB10 ist in den bereitgestellten Ergebnissen bei der Prompt-Verarbeitung langsamer. Das System ist energieeffizienter, bietet viermal so viel aggregierten Speicher und schließt den vollständigen 256K-Qwen-Test mit brauchbarer Generierungsgeschwindigkeit ab.
Wenn du kurze Prompts ausführst und Prompt-Aufnahme wichtig findest, hat 5060ti-x2 einen engen Anwendungsfall. Für ein 27B-Modell ist der größere gemeinsame Speicherpool die bessere Wahl, weil Modell und Kontext einen kohärenten Arbeitssatz teilen. Gemeinsamer Speicher bleibt vorzuziehen, sobald PCIe-Transfers in den Inferenzpfad gelangen.
Der Benchmark zeigt nicht, dass zwei RTX 5060 Ti Qwen 3 27B nie starten. Die Daten zeigen, warum das Starten des Modells etwas anderes ist als das gute Ausführen der Arbeitslast.
Grenzen des Benchmarks
Der bereitgestellte Bericht nennt die wörtlichen Ollama-Tags, dokumentiert aber keine aufgelösten Manifest-Digests, Modellversionen, CPU, Leistungsmessungen oder Kühlung. Er nennt außerdem PCIe Gen4 x16 für 5060ti-x2 und aktuelle NVIDIA-Linux-Treiber zum Testzeitpunkt. Behandle die Werte als beobachteten Systemvergleich, nicht als allgemeines Ranking jedes RTX-5060-Ti-Paars und jeder GB10-Implementierung.
Die Hardwaredaten oben stammen von NVIDIA. Die Leistungswerte stammen aus den für diesen Artikel bereitgestellten Benchmarkdaten.
Quellen
- Ollama Qwen3.8-Modellbibliothek
- Ollama GPT-OSS-Modell-Tags
- Reichen 16 GB VRAM für ernsthafte lokale LLM-Arbeit?
- 32 GB VRAM für Qwen 27B
- GPU-Kontextleitfaden für lokale KI
- Qwen3.8-27B-GPU-Benchmarks auf Vast.ai
- Vollständige Workstation mit zwei RTX 5060 Ti 16 GB
- NVIDIA-DGX-Spark-Liste im US-Marktplatz
- AMD-Ryzen-AI-Halo-Linux-Liste mit 128 GB
- Tom’s-Hardware-Test von Strix Halo gegen GB10
- Aktuelle RTX-5060-Ti-Preisprüfungen
Related Posts